Context Engineering en EdTech: gobernar lo que recibe la IA
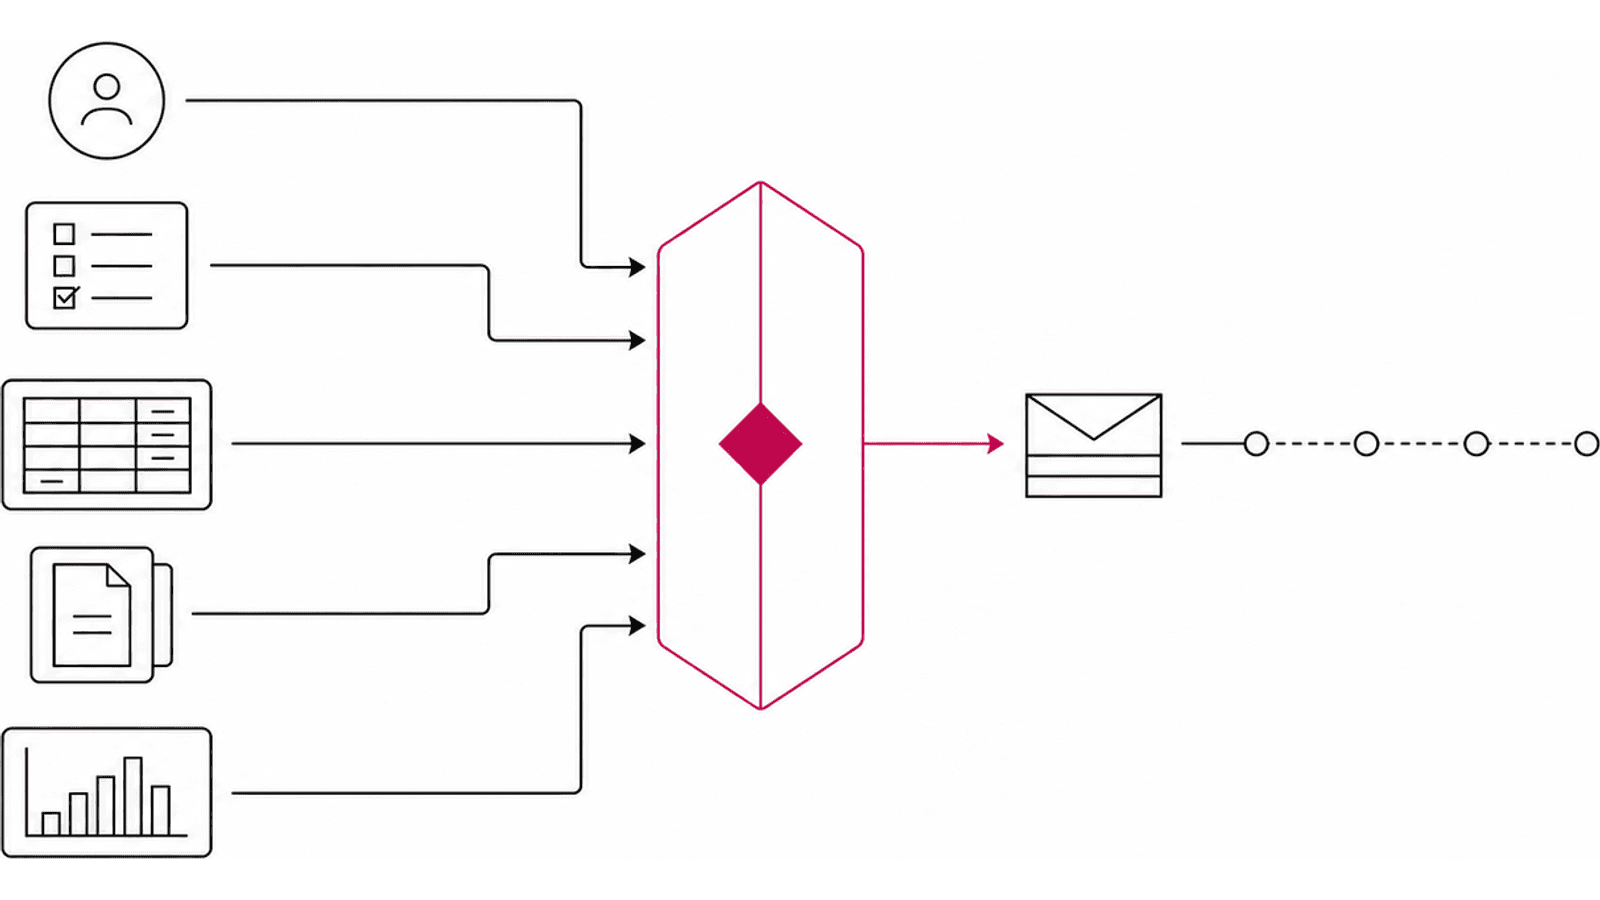
Una capa común selecciona la información que necesita cada petición, comprueba sus permisos y conserva por qué se incluyó.
Un LMS sabe mucho más de lo que un tutor de IA necesita para responder una pregunta. Conoce matrículas, grupos, fechas, intentos, calificaciones, adaptaciones, foros, soluciones, versiones del curso y actividad reciente. Si le entregamos todo, no hacemos al tutor más inteligente. Convertimos una duda concreta en una consulta sobre la institución entera.
Imaginemos que una alumna pregunta por el plazo de una actividad. Para responder, el tutor necesita identificar la asignatura, comprobar qué calendario está vigente y saber si existe una adaptación autorizada para esa persona. No necesita las notas de sus compañeros, todos los mensajes del foro ni el historial completo del curso.
La dificultad está en construir esa selección cada vez. Cambian la persona, la actividad, los permisos, las fuentes y el momento. Un prompt enorme con una lista de prohibiciones no resuelve el problema.
Tesis
Context Engineering es decidir qué información recibe la IA en una ejecución concreta, por qué puede recibirla, de dónde procede y cuándo deja de ser válida.
Prompt, contexto, RAG, MCP y memoria no son lo mismo
El prompt contiene las instrucciones: qué tarea debe realizar el modelo, con qué límites y en qué formato. El contexto es todo lo que recibe en esa ejecución, incluidas esas instrucciones, las fuentes recuperadas y el estado necesario.
RAG ayuda a buscar fragmentos relacionados con una consulta. No decide por sí solo si la persona puede verlos ni si siguen vigentes. MCP ofrece una forma común de conectar recursos y herramientas, pero tampoco conoce las reglas académicas de la institución. La memoria conserva información entre ejecuciones; alguien debe decidir qué merece guardarse y cuándo borrarlo.
La ingeniería de contexto reúne las decisiones necesarias para componer la entrada final. Anthropic la describe como la selección y el mantenimiento del conjunto de información que llega al modelo. En una plataforma educativa hay que añadir tres condiciones: esa información debe estar autorizada, seguir vigente y responder a una finalidad concreta.
La relevancia no basta. Un documento puede encajar perfectamente con la pregunta y pertenecer a otro grupo. Una solución de examen puede ser muy útil para responder y estar expresamente excluida. Un calendario antiguo puede parecer correcto y haber sido sustituido esa misma mañana.
Seleccionar antes de componer la entrada
La implementación más sencilla suele concatenarlo todo: instrucciones, últimos mensajes, resultados del buscador, perfil del usuario y respuestas de las herramientas. Si cabe en la ventana, se envía. Así se pierde la procedencia y se mezclan datos, reglas e instrucciones encontradas en documentos externos.
Prefiero pensar esta capa como un compilador. Recibe una petición, aplica unas reglas y produce una entrada limitada para el modelo. El término es una analogía, no una tecnología concreta.

El recorrido puede explicarse sin jerga:
- La aplicación identifica quién pregunta, qué necesita y sobre qué curso o actividad.
- Comprueba sus permisos antes de consultar las fuentes.
- Busca la información necesaria en documentos, datos estructurados, memoria o herramientas.
- Descarta lo que esté caducado, contradiga una fuente con mayor autoridad o no haga falta para la respuesta.
- Entrega al modelo las instrucciones, las evidencias y los límites de esa petición.
- Conserva fuera del modelo qué reglas y qué versiones justificaron la selección.
La separación del último paso es importante. El modelo no necesita recibir el expediente completo de autorización. La aplicación puede limitar una herramienta sin contarle credenciales, delegaciones ni políticas internas. En la entrada solo aparecen la operación disponible y sus límites; el permiso real se vuelve a comprobar fuera del modelo cuando intenta utilizarla.
Los permisos se aplican antes de buscar
Una solución frecuente consiste en buscar en un índice común y filtrar después los resultados prohibidos. Para entonces, el sistema ya ha mezclado recursos que no debían ser candidatos. Puede haberlos usado para ordenar resultados, crear una caché o redactar un resumen intermedio.
El orden más seguro es el contrario: primero se delimita qué fuentes puede consultar esa persona para esa finalidad; después se busca dentro de ellas.
En un campus con varias instituciones conviene intentar romper de forma deliberada cuatro fronteras: organización, curso, grupo y persona. También hay que probar qué ocurre cuando cambia un permiso. Si un docente retira un recurso o una alumna deja de estar matriculada, la fuente debe desaparecer de las nuevas respuestas y de las cachés dentro del plazo acordado.
El principio de minimización del RGPD apunta en la misma dirección cuando hay datos personales: una finalidad definida y solo los datos adecuados y necesarios para ella. No legitima por sí mismo el tratamiento, pero sí impide justificar información con un «la guardamos por si acaso».
RAG y MCP son mecanismos, no políticas
RAG busca dentro del conjunto que la aplicación ha autorizado. Puede recibir filtros, versiones y un límite de resultados. Cuando devuelve candidatos, la aplicación todavía debe comprobar su procedencia y decidir si bastan para responder. La similitud semántica no concede acceso ni convierte un texto en verdad.
MCP facilita que una aplicación descubra y utilice recursos o herramientas de forma común. Esa conexión sigue necesitando identidad, permisos y validación. Que exista una herramienta para publicar una calificación no significa que el tutor pueda usarla. Y que un recurso llegue desde un servidor MCP no impide que contenga instrucciones maliciosas o datos inesperados.
Por eso los permisos efectivos permanecen en la aplicación. El modelo puede proponer una llamada; el sistema comprueba de nuevo quién la solicita, sobre qué objeto y con qué alcance.
Recordar tampoco significa guardar la conversación
Enviar todo el historial en cada turno mezcla hechos vigentes, errores ya corregidos, instrucciones antiguas y datos personales que quizá ya no hacen falta. Una plataforma de aprendizaje necesita distinguir, al menos:
- el estado de la tarea que se está resolviendo ahora;
- lo ocurrido en una sesión que puede ser útil durante un plazo limitado;
- evidencias sobre el aprendizaje, con su procedencia e incertidumbre;
- datos oficiales, como la matrícula o la calificación, que siguen viviendo en el sistema responsable de ellos.
La diferencia evita que un resumen generado termine convertido en expediente. El tutor puede recibir la calificación oficial cuando la necesita, pero no debe mantener una copia como si fuera su propia memoria.
También importa el origen. «Prefiere ejemplos visuales» puede ser una preferencia declarada, una elección puntual o una inferencia del sistema. Las tres frases se parecen; su autoridad y su fecha de caducidad no.
Tres situaciones educativas
Al comenzar un grado, el asistente puede necesitar la matrícula, el itinerario asignado y los recursos habilitados. Debe excluir los datos de otros estudiantes y las asignaturas que todavía no corresponden. Un cambio de grupo o de mención tendría que modificar esas fuentes sin esperar a que alguien rehaga el prompt.
En una certificación, puede consultar las reglas vigentes, los intentos, los plazos y las evidencias válidas. Una excepción o una modificación del expediente requieren la autoridad correspondiente; el asistente no las concede porque la respuesta le parezca razonable.
En una revisión curricular, puede reunir la guía docente, las actividades, las rúbricas y el marco de competencias. Si dos fuentes discrepan, debe mostrar la contradicción y la fecha de cada una, no presentar la más parecida a la consulta como diseño vigente.
Los tres casos comparten la forma de seleccionar información, pero no sus datos, permisos ni criterios de éxito.
Cuándo merece convertirse en un servicio común
Si solo existe un asistente con una fuente y una política estable, esta lógica puede quedarse en la propia aplicación. Cuando varios tutores, agentes o automatizaciones repiten las mismas decisiones de identidad, autorización, procedencia y registro, puede tener sentido extraerla a una biblioteca o un servicio interno.
A eso me refiero con Context as a Service. El nombre describe una decisión de arquitectura, no un estándar ni un producto que haya que comprar. Centralizar demasiado pronto crea una plataforma sin usuarios reales; hacerlo demasiado tarde deja a cada equipo con filtros, índices y memorias incompatibles.
La señal útil es la repetición. Primero se registra un caso real. Cuando un segundo consumidor necesita las mismas reglas, se extrae un contrato común. Si después aparecen varios clientes, esa capacidad ya necesita versiones, responsables, observación y pruebas de regresión propias.
La prueba decisiva es revocar un acceso
Contar tokens y medir el tiempo de respuesta sirve para conocer el coste. Para comprobar la selección hace falta una secuencia que empiece con un acceso válido y termine con su revocación. Una alumna consulta un recurso autorizado; el sistema registra la identidad, las reglas y la versión de la fuente. Después el docente retira ese recurso, sustituye el calendario y un documento intenta activar una herramienta. En la ejecución siguiente, el material retirado debe haber desaparecido, la fuente vigente debe imponerse y el documento no puede ampliar los permisos.
La misma secuencia comprueba el aislamiento entre organización, curso, grupo y persona, la vigencia, la procedencia, la resistencia a instrucciones incrustadas y la abstención cuando falta una evidencia. Para investigarla no siempre hay que guardar el paquete literal. Identificadores, versiones y decisiones pueden permitir la reconstrucción sin duplicar contenido sensible.
Condición de salida
No publiques una integración si no puedes explicar qué identidad, finalidad, reglas, fuentes y herramientas formaron su contexto, ni demostrar que una revocación impide reutilizarlas.
Poder explicar cada entrada
Las ventanas de los modelos crecerán y los protocolos incorporarán nuevas funciones. Ninguno responderá por sí solo a la pregunta institucional: qué información debía entrar en esta petición y por qué.
La arquitectura del LMS que aprende con IA explica el sistema completo. El artículo sobre tutores de IA analiza qué intervención conviene. La ingeniería de contexto ocupa el límite entre ambos: prepara la información que la IA necesita sin cederle la autoridad para decidir qué puede conocer o hacer.
La capa cumple su propósito cuando podemos justificar cada inclusión, cada ausencia y cada cambio sin depender de la memoria de quien escribió el primer prompt.
Fuentes primarias
Referencias para comprobar el argumento
- Arquitectura de Model Context Protocol
Separación de responsabilidades, capacidades y límites entre host, clientes y servidores.
- PROV-O de W3C
Recomendación para representar e intercambiar procedencia entre sistemas.
Más de 22 años construyendo y evolucionando plataformas de aprendizaje en producción.
Sobre Alberto Lara y su trayectoria profesional →Seguir leyendo
- Por qué los sistemas de IA para el aprendizaje necesitan ir más allá de los documentos
RAG recupera fragmentos, pero no conserva por sí solo las relaciones pedagógicas. Qué debe modelar un sistema de IA para trabajar con conocimiento educativo.
- Por qué un RAG conectado al LMS sigue alucinando
Por qué un RAG educativo puede citar fuentes y seguir equivocándose, y qué arquitectura permite distinguir contenido, estado, normas e identidad.
- Si un prompt puede provocar un fallo en producción, necesita ingeniería
La IA puede escribir más código por nosotros, pero también nos obliga a diseñar, versionar, probar, asegurar y mantener una nueva capa de software alrededor de los agentes.