Por qué un RAG conectado al LMS sigue alucinando
Encontrar pasajes parecidos no resuelve la autoridad, la vigencia, los permisos ni la falta de información. En un LMS, todo eso forma parte de la respuesta.
Un alumno pregunta: «¿Puedo entregar el trabajo el lunes?». El buscador encuentra la guía de la asignatura, un aviso del profesor y una copia del calendario. Los tres textos hablan de la entrega. El modelo los lee y responde que sí.
La respuesta puede ser falsa. La guía pertenece al curso anterior, el aviso iba dirigido a otro grupo y el calendario general no incluye la ampliación individual registrada para ese alumno. Elegir el fragmento más parecido a la pregunta no resuelve ninguno de esos conflictos.
En Moodle 5.1, la posibilidad de entregar no sale de una sola fecha. La actividad tiene un plazo y una fecha límite; pueden existir excepciones para los grupos del alumno y otra excepción individual que prevalece campo a campo. Una prórroga se guarda aparte y amplía la fecha final cuando es posterior a la ya calculada. Antes de comprobar todo eso, una marca de bloqueo puede cerrar la entrega sin cambiar ninguna fecha.
Son varios registros y un orden de precedencia. Un buscador semántico sobre documentos no recupera ese estado por sí solo, y el modelo no puede saber qué pieza falta si la aplicación no la consulta.
El problema aparece cuando tratamos el LMS como una carpeta llena de textos. Un LMS también guarda matrículas, grupos, plazos efectivos, intentos, calificaciones y normas que cambian con el tiempo. Para responder hay que saber qué fuente manda, desde cuándo, para quién y si el estado actual la modifica.
Un fragmento puede ser muy relevante para una pregunta y, aun así, no servir
para responderla a esa persona.
En el mapa de la nueva ingeniería de la IA, RAG ocupa una responsabilidad concreta: recuperar información. No decide por sí solo si esa información está autorizada, sigue vigente o basta para contestar. Cuando la respuesta depende de prerrequisitos, cobertura o equivalencias, también hay que conservar las relaciones explícitas entre esas piezas.
Conectar una fuente no la convierte en verdad
La generación aumentada con recuperación añade información externa a la entrada del modelo. Suele mejorar las respuestas cuando el conocimiento falta o cambia, pero el modelo sigue generando texto y puede introducir afirmaciones que la fuente no contiene.
El perfil de IA generativa de NIST incluye la confabulación entre los riesgos de estos sistemas. La investigación específica sobre RAG confirma que recuperar documentos no la elimina.
RAGTruth reunió casi 18.000 respuestas y anotó afirmaciones no respaldadas o contradictorias. Astute RAG estudió qué ocurre cuando los pasajes son insuficientes o entran en conflicto con el conocimiento del modelo. NoMIRACL mostró la dificultad de abstenerse cuando los documentos no contienen la respuesta y de reconocer la evidencia cuando sí aparece.
Esos trabajos no predicen la tasa de error de un LMS concreto. Sí desmontan una idea cómoda: conectar una base vectorial no garantiza que el sistema encuentre lo necesario ni que utilice bien lo encontrado.
Recuperar más fragmentos tampoco arregla automáticamente el problema. Puede aumentar la cobertura, pero también introducir versiones antiguas y diluir la evidencia importante.
En el LMS conviven fuentes distintas
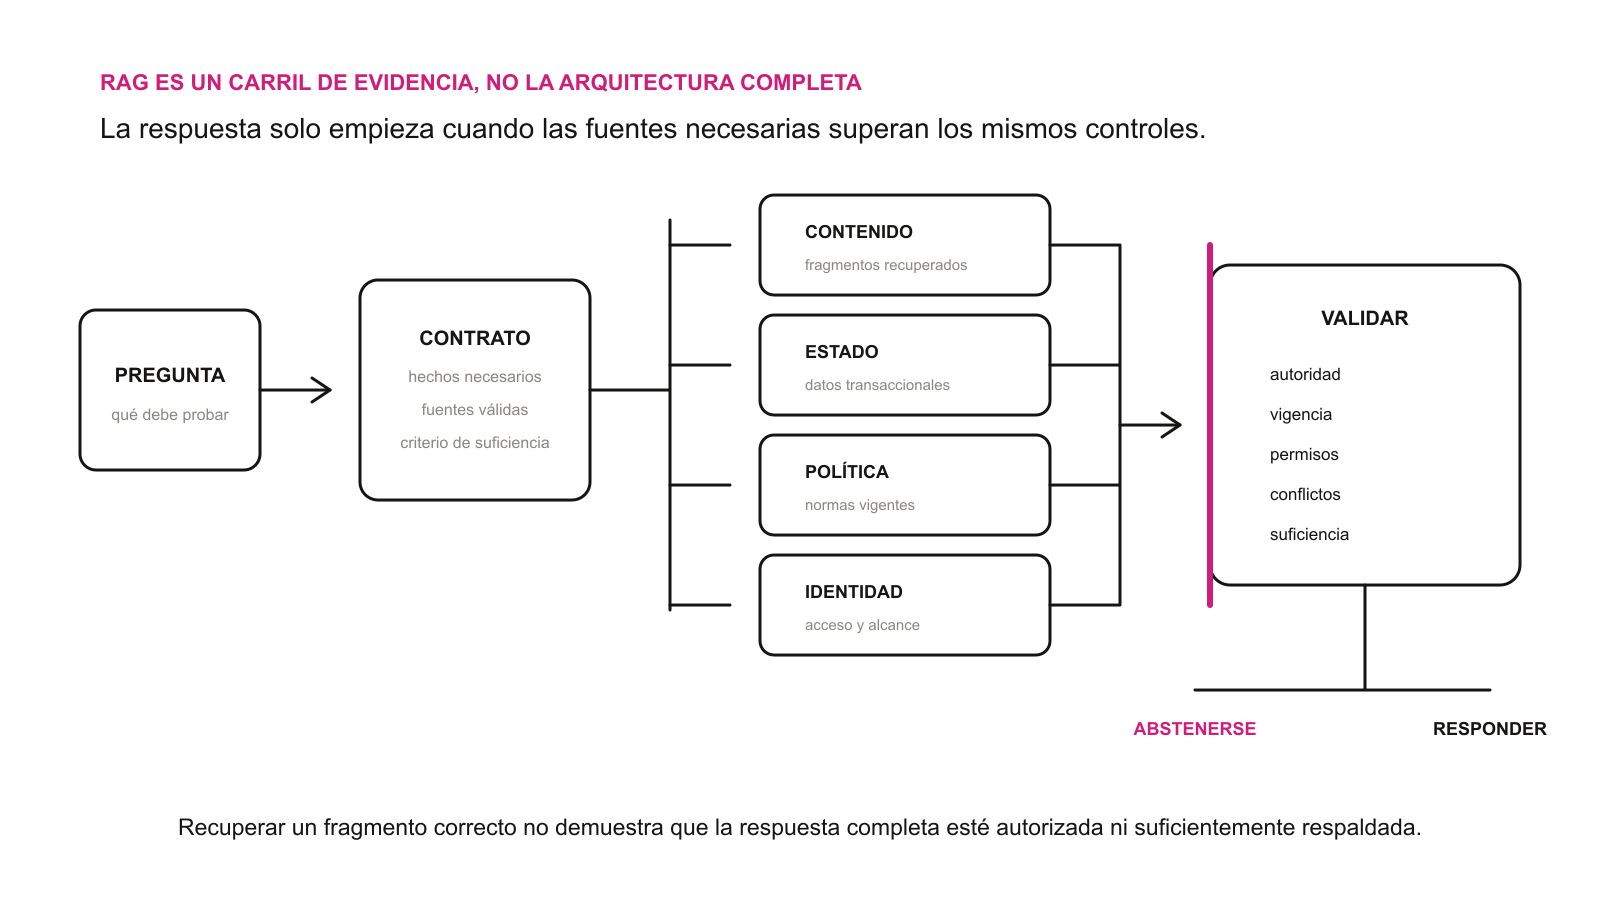
La pregunta del lunes muestra cuatro tipos de información que pueden hacer falta:
| Tipo | Ejemplo | Dónde conviene consultarlo |
|---|---|---|
| Contenido | Guía, tema, rúbrica | Buscador semántico o léxico |
| Estado actual | Plazo efectivo, intento, prórroga o adaptación, nota publicada | API o consulta directa al LMS |
| Norma | Regla general y orden de precedencia | Documento oficial y código o política ejecutable versionados |
| Identidad y acceso | Usuario, grupo, matrícula y permisos | Sistema de identidad y permisos |
Un índice vectorial puede localizar una explicación dentro de un documento. Es una mala fuente principal para confirmar si un intento sigue abierto. Ese dato debe leerse del sistema que lo mantiene. Del mismo modo, encontrar una rúbrica no demuestra que quien pregunta pueda ver la evaluación de otra persona.
Al convertirlo todo en fragmentos y mezclarlos, la similitud semántica acaba ocupando el lugar de tres decisiones que no puede tomar: autoridad, vigencia y permiso. La ingeniería de contexto se ocupa precisamente de conservar esas diferencias antes de construir la entrada del modelo.
Primero hay que entender la pregunta
«Explícame la diferencia entre validez y fiabilidad» puede responderse con el contenido oficial del curso. «¿He entregado?» exige identificar al alumno, la actividad y su intento. «Envía mi trabajo» añade permisos, comprobaciones y un efecto que habrá que verificar.
Antes de buscar, el sistema necesita clasificar qué clase de pregunta tiene delante y qué hechos serían necesarios para resolverla:
- una pregunta conceptual necesita contenido canónico;
- un procedimiento necesita instrucciones y configuración vigentes;
- un dato personal necesita identidad y estado actual;
- una norma o un plazo necesitan la regla general y las excepciones aplicables;
- una acción necesita además autorización y confirmación del efecto.
Si falta el curso, la actividad o la zona horaria, lo correcto puede ser preguntar. Pedir una aclaración evita que una frase ambigua termine convertida en una respuesta categórica.
Cada evidencia necesita algo más que texto
Un fragmento suele guardar el texto, un identificador y una puntuación de similitud. Para una decisión educativa también hace falta saber de qué fuente procede, qué versión es, a qué curso o grupo pertenece, quién puede verla y durante qué fechas está vigente.
Con esos datos, la aplicación puede excluir un documento antes de que llegue al modelo, dar prioridad a una fuente oficial, detectar dos reglas incompatibles y comprobar si falta algún hecho imprescindible. El modelo no debería adivinar que una guía es oficial por su tono ni que una fecha de edición invalida otra.
La procedencia visible sirve al alumno que quiere comprobar la respuesta. Pero también sirve al equipo que, semanas después, necesita saber por qué el sistema contestó de esa forma.
La vigencia también tiene una latencia
Un profesor puede cambiar una fecha o publicar un aviso urgente a medianoche. El dato ya es distinto en Moodle, pero un índice documental actualizado por lotes puede seguir sirviendo la versión anterior hasta la siguiente sincronización. Durante ese intervalo, el buscador recupera con éxito una fuente que ya no describe el estado vigente. No es un fallo que se arregle cambiando el prompt ni el modelo.
Los datos dinámicos, como el plazo efectivo o el bloqueo de una entrega, deben consultarse en el sistema que los mantiene. Para los documentos hace falta definir cómo se detecta un cambio, cómo se invalida la versión anterior y cuánto puede tardar en estar disponible la nueva. La traza debe conservar tanto la versión de la fuente como el momento de extracción; una fecha visible dentro del texto no demuestra que el índice esté al día.
La prueba de vigencia mide ese intervalo. Modifica una fuente, comprueba cuándo deja de aparecer la copia anterior y verifica que una caché no prolonga su uso. Si el servicio no puede cumplir el plazo acordado, la respuesta debe consultar la fuente directa o declarar el límite.
No todo error es una alucinación
Utilizar una sola palabra para todos los fallos dificulta mucho su corrección. En este tipo de sistema pueden ocurrir, al menos, cuatro cosas:
- Falta la evidencia. El buscador no encontró el documento, el filtro lo excluyó o el dato vivía en una API que nadie consultó.
- Las fuentes chocan. Hay dos versiones o normas con distinta autoridad y el sistema no sabe cuál corresponde.
- El modelo utiliza mal una fuente correcta. Omite una condición, mezcla dos fragmentos o añade una excepción inexistente.
- La respuesta no estaba autorizada. Los hechos son correctos, pero pertenecen a otro alumno o grupo. Esto es una filtración, no una alucinación.
La distinción indica dónde mirar. Un prompt no repara un índice que omite la fuente. Cambiar de modelo no corrige una regla de acceso aplicada demasiado tarde.
Saber cuándo falta información
Para contestar «¿puedo entregar el lunes?» se necesita, como mínimo, el plazo vigente, la zona horaria, el estado actual de la actividad y cualquier excepción aplicable al alumno. Si no se pueden consultar las adaptaciones personales, una respuesta rotunda no estaría justificada.
El asistente todavía puede ayudar: informa del plazo general, explica la zona horaria y reconoce que no puede confirmar una ampliación individual. Esa respuesta es menos fluida que un «sí», pero mucho más fiable.
La suficiencia no consiste en acumular documentos. Consiste en cubrir cada hecho necesario con una fuente autorizada y mostrar los conflictos que no puedan resolverse. Para una explicación quizá baste un pasaje. Para una decisión personal hacen falta identidad y estado actual. Para actuar, además, se necesita autorización. El mismo principio se aplica a una integración mediante MCP y Moodle.
Verificar afirmaciones, no solo añadir citas
Una cita ayuda, pero puede estar junto a una frase que no demuestra. Antes de mostrar la respuesta, la aplicación debería relacionar cada afirmación factual con el documento, el dato o la regla que la sostiene.
Parte de esa comprobación puede hacerse con reglas y parte con otro modelo. El verificador tampoco es infalible: necesita sus propios casos de prueba y debe poder declarar que no llega a una conclusión. Cuando el impacto sea alto y falte evidencia, la salida segura será abstenerse o pedir revisión humana.
La traza de una respuesta debería conservar las versiones y las decisiones necesarias para investigarla, sin copiar datos personales por rutina. Registrar todo no es sinónimo de poder explicar lo ocurrido.
Cómo evaluar el conjunto
Una media de respuestas correctas es insuficiente. La evaluación necesita separar tres fallos. El primero está en la evidencia: si se recuperan todos los hechos necesarios y se excluyen el ruido y las versiones antiguas. El segundo está en la respuesta: si cada afirmación queda respaldada y se respetan las fechas y la autoridad de las fuentes. El tercero está en el control: si el sistema mantiene las fronteras de curso, grupo, rol y persona, y se abstiene cuando falta una pieza crítica.
El conjunto debe incluir preguntas normales, formulaciones coloquiales, errores tipográficos, conversaciones de varios turnos y ataques que intenten cambiar las reglas. También necesita preguntas sin respuesta. Si todas pueden contestarse, la evaluación premiará a un sistema que nunca se abstiene.
Separar las pruebas permite atribuir los fallos y saber si hay que corregir la búsqueda, la selección de fuentes, los permisos o la generación.
Un piloto pequeño enseña más
No empezaría indexando todo el campus. Elegiría un curso, preguntas conceptuales y preguntas sobre el plazo de una actividad. Conectaría el contenido oficial y la consulta autorizada al estado real de esa actividad.
El piloto debería incluir una guía antigua, dos grupos, una excepción individual, un conflicto y preguntas sin respuesta. Se cierra cuando ninguna evidencia cruza entre cursos, grupos o personas sin permiso; la versión vigente prevalece sobre la más parecida; cada afirmación factual conserva su respaldo; los conflictos permanecen visibles; la falta de una excepción personal obliga a declarar ese límite; y cada fallo puede atribuirse a una parte del sistema.
Ese piloto aporta más información que cargar miles de PDF y comprobar que el chatbot añade citas. También prepara el camino hacia un LMS que gobierna la evidencia.
Recuperar mejor no es gobernar mejor
Un RAG puede tener buenos embeddings, búsqueda híbrida, reordenación de resultados y un modelo potente, y seguir contestando mal. Esas mejoras ayudan a encontrar información. No deciden qué fuente manda, para quién rige ni si falta un dato imprescindible.
El cambio consiste en empezar por otra pregunta: ¿qué hechos autorizados hacen falta para responder a esta persona, en este curso y en este momento?
Cuando el sistema puede responderla, RAG ocupa un lugar claro dentro de la arquitectura. Cuando no, añadir fragmentos solo consigue que la respuesta equivocada parezca mejor documentada.
Más de 22 años construyendo y evolucionando plataformas de aprendizaje en producción.
Sobre Alberto Lara y su trayectoria profesional →Seguir leyendo
- Por qué los sistemas de IA para el aprendizaje necesitan ir más allá de los documentos
RAG recupera fragmentos, pero no conserva por sí solo las relaciones pedagógicas. Qué debe modelar un sistema de IA para trabajar con conocimiento educativo.
- Context Engineering en EdTech: gobernar lo que recibe la IA
Qué es Context Engineering y cómo combinar identidad, fuentes, permisos, RAG, MCP y memoria sin entregar a la IA más información de la necesaria.
- Prompt Engineering en producto: diseño, pruebas, versiones y producción
En un producto, el Prompt Engineering no termina cuando una instrucción produce una buena respuesta. Empieza al definir el comportamiento esperado y continúa con pruebas, versiones, observación y mantenimiento.