Loop Engineering: dejar de dirigir al agente paso a paso
El agente puede ejecutar una tarea, pero alguien todavía tiene que comprobar el resultado y decidir si repite, cambia de estrategia o se detiene.
Abres una incidencia, se la explicas a un agente y esperas. El agente localiza los archivos, modifica el código y te devuelve un parche. Tú lees el cambio, ejecutas las pruebas y encuentras un fallo. Copias el error, escribes otro prompt y esperas una segunda respuesta. Cuando las pruebas pasan, revisas el resultado y decides si ya se puede integrar.
Parece que el agente ha realizado el trabajo, pero las decisiones importantes siguen siendo tuyas. Tú has elegido la incidencia, has aportado el contexto, has interpretado las pruebas y has decidido cuándo continuar y cuándo terminar. El agente ha ejecutado varias acciones; tú has sido el bucle.
Loop Engineering consiste en diseñar el mecanismo que, después de cada ejecución del agente, obtiene una evidencia, actualiza el estado y decide si debe repetir, cambiar de estrategia, pedir ayuda o terminar. El sistema también puede buscar y seleccionar sus propias tareas, pero esa automatización es una capacidad adicional, no lo que convierte una repetición en un bucle de realimentación.
La expresión es reciente. Addy Osmani la utiliza para describir el paso de dirigir a un agente turno a turno a diseñar el sistema que lo dirige. Tomo de ahí la idea central, aunque aquí me concentro en el bucle de realimentación. Un horario, la captación automática de tareas o varios agentes pueden formar parte del diseño, pero no son requisitos para que el resultado de un intento provoque otro.
Qué cambia cuando diseñas el bucle
Imagina que una actualización rompe la importación de un paquete SCORM en una plataforma de aprendizaje. En un trabajo asistido, una persona prepara el entorno, pide una corrección, ejecuta las pruebas y decide qué hacer con el resultado. Puede apoyarse mucho en la IA, pero tiene que volver para iniciar cada paso.
Un bucle diseñado para ese tipo de fallo podría hacer lo siguiente:
- recibir la incidencia elegida y fijar la versión del código y el resultado esperado;
- preparar una rama aislada y un entorno de prueba reiniciable, con su propia base de datos, almacenamiento y procesos en segundo plano;
- entregar al agente el código, las convenciones y la prueba que falla;
- ejecutar la corrección propuesta;
- volver a importar un paquete de regresión versionado y comprobar que el manifiesto se procesa, que aparecen los recursos y actividades esperados y que la actividad de lanzamiento se puede abrir;
- si la prueba falla, entregar ese fallo como información para el siguiente intento;
- si pasa, dejar el cambio y la evidencia preparados para que una persona los revise;
- registrar lo ocurrido y cerrar, repetir o escalar la incidencia según el resultado.
El modelo puede ser el mismo en todos los intentos. Lo que ha cambiado es el sistema que lo rodea. Ya no necesita que alguien copie cada error, recuerde lo que se probó y redacte la siguiente instrucción. Tampoco recibe permiso para seguir indefinidamente: trabaja dentro de un objetivo, un entorno y unas salidas que se han definido antes.
El bucle no es un while alrededor de un prompt
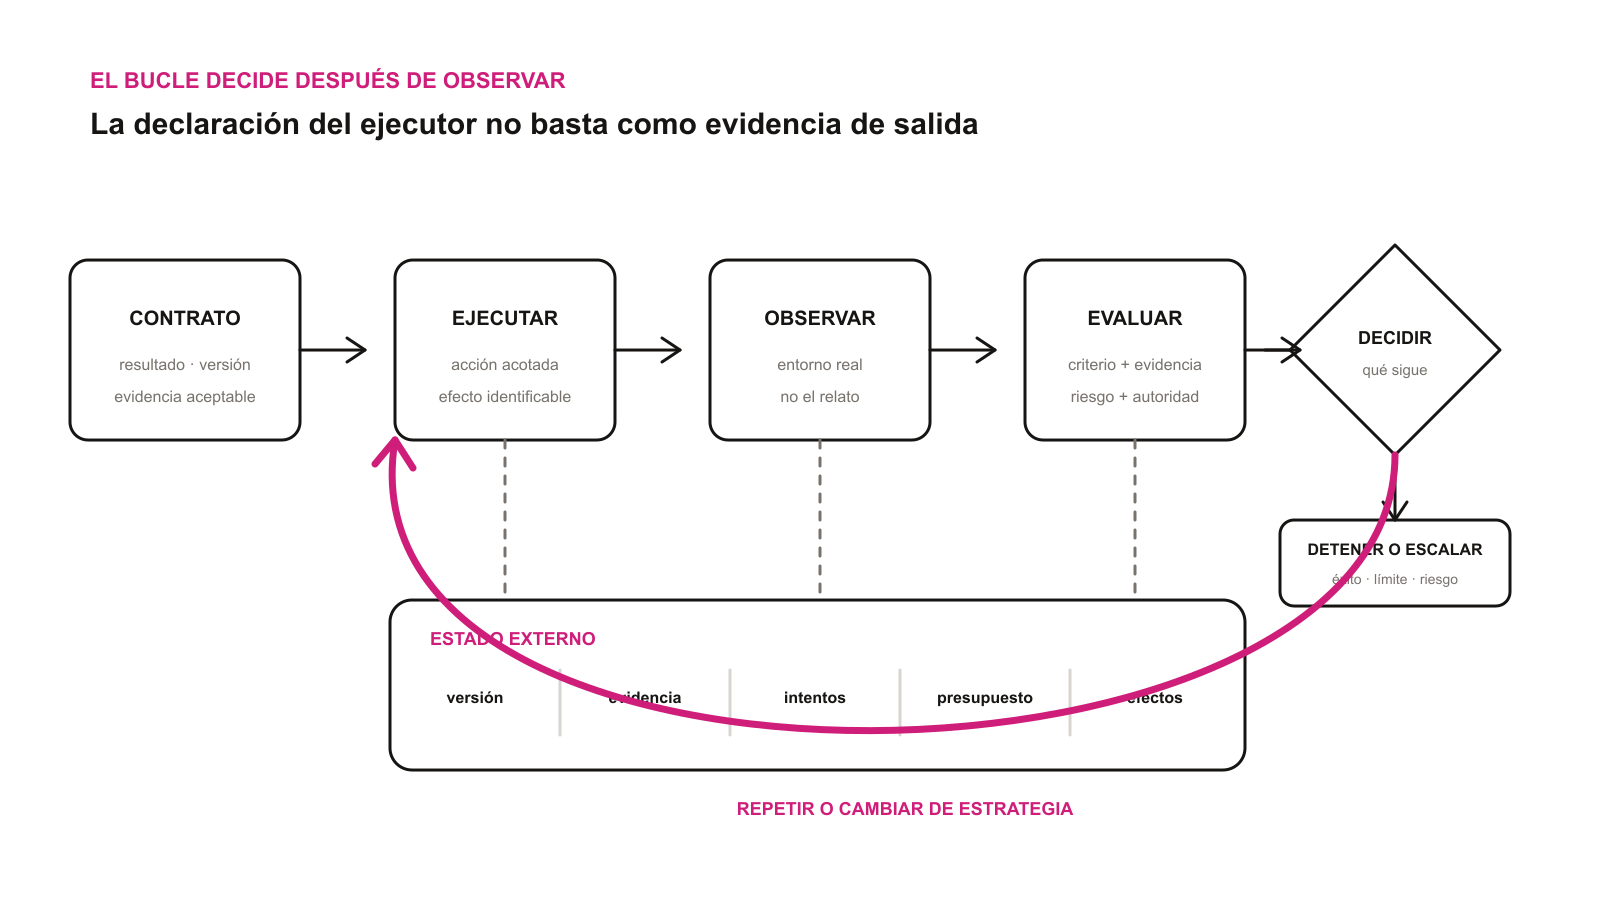
La versión más sencilla parece fácil de programar: ejecutar al agente y repetir hasta que responda que ha terminado. Ese diseño entrega la condición de salida a quien acaba de producir el resultado. Si el agente se equivoca, puede confirmar su propio error y cerrar el trabajo.
También puede ocurrir lo contrario. Si nunca encuentra suficiente evidencia para declararse satisfecho, continúa gastando tiempo y dinero, acumula contexto y prueba variantes sin registrar qué resultado obtuvo ni descartar las vías que ya fallaron. La repetición no corrige por sí sola una mala especificación ni convierte una comprobación débil en una prueba.
El bucle aporta valor cuando cada vuelta responde tres preguntas con datos que el sistema puede conservar:
- ¿qué cambió realmente después del intento?;
- ¿ese cambio acerca la tarea a una condición de salida verificable?;
- ¿conviene repetir, cambiar de estrategia, pedir ayuda o detenerse?
Además, al menos una de esas decisiones debe poder devolver el mismo objetivo a otra ejecución. Un flujo lineal también puede elegir entre dos ramas según un resultado, pero termina sin regresar a una etapa anterior.
Si la respuesta procede únicamente del relato del agente, el ciclo sigue dependiendo de una declaración. Para corregir una importación SCORM, la evidencia no es «he arreglado el importador», sino el resultado de importar el paquete de regresión con el código candidato y comprobar las condiciones fijadas para el curso resultante.
| Pieza | Qué gobierna | Relación con la repetición |
|---|---|---|
| Workflow | El orden de pasos y decisiones | Solo vuelve atrás si el flujo declara esa transición |
| Harness | El contexto, las herramientas, los permisos y el aislamiento de una ejecución | Prepara y limita cada intento, pero no decide por sí solo repetirlo |
| Loop | La transición que sigue a la evidencia observada | Puede devolver el mismo objetivo a otro intento, escalarlo o cerrarlo |
El agente ejecuta dentro del harness y puede recorrer un workflow. El mecanismo de control del bucle decide qué ocurre entre intentos. Esta es la frontera que evita llamar Loop Engineering a cualquier proceso que incluya un agente.
Qué hay que diseñar de verdad
La parte difícil no está en trazar una flecha que regresa al agente. Está en expresar las decisiones que tomaba una persona entre dos prompts como reglas comprobables y transiciones de estado que el sistema pueda aplicar.
Qué objetivo entra. La tarea puede llegar de una persona, de una cola o de una búsqueda automática. En todos los casos debe quedar identificada junto con la versión sobre la que se trabaja. Una corrección acotada, reversible y cubierta por pruebas admite más autonomía que un cambio de permisos o una migración de datos.
Qué recibe el agente. La tarea debe identificar el objeto, su versión, el resultado esperado, las restricciones y las herramientas permitidas. Un contexto enorme no sustituye esa selección. Solo añade material que el agente tendrá que interpretar en cada vuelta.
Cómo se comprueba el resultado. La prueba debe ejecutarse sobre el objeto que podía cambiar, no sobre el resumen de la conversación. En el ejemplo, el entorno importa el paquete de regresión y comprueba el curso creado. Que el agente haya modificado un archivo no demuestra que el fallo haya desaparecido.
Qué información pasa al siguiente intento. El agente necesita el error, la prueba que lo produjo y los cambios ya ensayados. Devolverle todo el historial sin distinguir hechos, hipótesis y resultados puede hacer que repita una vía que ya falló.
Qué queda fuera de la conversación. Si el bucle debe sobrevivir a una interrupción, un cambio de sesión o la reducción del contexto, la incidencia, la rama, la versión del código, los intentos y sus pruebas deben persistir en un estado externo. Un resumen incompleto puede borrar justo la información que la siguiente ejecución necesita.
Qué ocurre si una ejecución se interrumpe. Antes de repetir una operación, el sistema debe comprobar si el cambio anterior llegó a aplicarse. De lo contrario, un reintento puede duplicar una notificación, una matrícula o un comentario. Recuperar no siempre significa empezar otra vez, sino volver al último estado que se puede demostrar.
Quién puede declarar que ha terminado. El productor no debería ser la única fuente del veredicto. Algunas condiciones pueden comprobarse con pruebas deterministas; otras necesitan una revisión separada o una decisión humana. El control debe corresponder al riesgo del cambio.
Qué presupuesto tiene. Antes de empezar se fijan los límites de intentos, tiempo o coste y la señal que cuenta como progreso. Si se agota uno de esos límites o varias vueltas no aportan ninguna evidencia nueva, el sistema deja de repetir y escala la incidencia. Las cifras dependen del trabajo; lo importante es que no aparezcan después de que el ciclo se haya descontrolado.
Cómo termina sin éxito. Además de «completado», hacen falta salidas para «bloqueado», «sin progreso», «límite alcanzado» y «requiere aprobación». Un ciclo que solo sabe terminar cuando todo sale bien se queda abierto precisamente en los casos más difíciles.
Estas decisiones son Loop Engineering. Las herramientas, los modelos y los agentes concretos pueden sustituirse, pero siguen haciendo falta las funciones de entrada, verificación, estado y control de salida.
El horario y la realimentación resuelven problemas distintos
La formulación práctica de Osmani incluye bucles por turnos, por objetivos, temporales y proactivos. Conviene distinguirlos porque no exigen las mismas decisiones. Ejecutar un prompt cada noche puede servir para revisar incidencias nuevas y terminar; el horario decide cuándo empieza cada ejecución, pero no obliga a repetir el trabajo anterior.
En un bucle orientado a un objetivo, el resultado sí puede devolver la tarea a otro intento. Si una prueba falla, el sistema conserva el error y repite; si las siguientes vueltas no aportan información nueva, se detiene; si pasa, envía el cambio a revisión. Un horario puede activar este ciclo, pero la transición de retorno es la que permite corregir el resultado anterior.
Tampoco hacen falta varios agentes para que exista. Uno puede ejecutar y otro revisar, pero el número no define el bucle. Lo define la conexión entre el resultado observado y la siguiente decisión.
La autonomía para cerrar termina donde deja de haber una prueba fiable
Un bucle permite delegar más ejecución, no delegar cualquier juicio. Si la tarea consiste en mejorar «la calidad» de una experiencia y nadie ha decidido qué significa mejorar, el sistema no tiene una condición de salida: solo puede producir cambios hasta que alguien diga basta.
También conviene mantener fuera del ciclo automático los efectos que no se pueden deshacer o comprobar con seguridad. Cambiar una calificación, cancelar una matrícula o enviar una comunicación al alumnado exige más autoridad que preparar un parche en una rama aislada. La intervención humana no rompe el bucle; es una de sus posibles salidas.
Para una tarea única, breve y determinista, un flujo convencional suele ser más barato de construir y más fácil de mantener. Diseñar estado, reintentos, aislamiento, verificación y recuperación compensa cuando una clase de tareas aparece con frecuencia o cuando una tarea larga exige varias iteraciones, puede avanzar sin supervisión continua y dispone de evidencia suficiente para decidir cuándo repetir, escalar o terminar.
Dónde encaja dentro de la ingeniería de IA
Prompt Engineering diseña y mantiene las instrucciones que condicionan una ejecución. Context Engineering prepara la información que esa ejecución necesita. Agent Engineering define las herramientas, los permisos y los límites del agente.
Loop Engineering trabaja entre una ejecución y la siguiente. Recibe el objetivo, incorpora el resultado observado al estado y aplica la condición que permite repetir, escalar o cerrar. Cuando ese ciclo forma parte de un producto con usuarios, identidad, seguridad, costes y operación, el problema se amplía a AI System Engineering.
La diferencia puede resumirse sin inventar otra taxonomía: mientras una persona lee cada respuesta y escribe el siguiente prompt, esa persona sigue dirigiendo el ciclo. Hay Loop Engineering cuando las reglas para comprobar el resultado, conservarlo y decidir qué viene después también se han diseñado.
Más de 22 años construyendo y evolucionando plataformas de aprendizaje en producción.
Sobre Alberto Lara y su trayectoria profesional →Seguir leyendo
- Agent Engineering: cuándo coordinar varios agentes y cuándo no
Cómo decidir entre código, un flujo, un agente o varios, y qué contratos, permisos, estado y pruebas necesita la coordinación.
- Memory Engineering: qué debe recordar, corregir y olvidar un agente
Cómo diseñar la escritura, recuperación, actualización y eliminación de la memoria de un agente sin convertir su historial en una fuente de errores.
- Si un prompt puede provocar un fallo en producción, necesita ingeniería
La IA puede escribir más código por nosotros, pero también nos obliga a diseñar, versionar, probar, asegurar y mantener una nueva capa de software alrededor de los agentes.