Deuda técnica en IA generativa: RAG, agentes y código generado
Lo que los sistemas de aprendizaje automático ya enseñaron hace una década y cómo aplicarlo hoy a datos, canalizaciones, evaluación y desarrollo dirigido por especificaciones
En muchos sistemas de inteligencia artificial (IA) en producción, el código específico del modelo es una fracción pequeña de la superficie técnica. La deuda se acumula también en los datos, las dependencias, la configuración, los procesos de entrenamiento, los consumidores y la monitorización. La IA generativa no ha corregido ese problema. Ha añadido corpus documentales, índices, instrucciones para el modelo —prompts—, proveedores externos y agentes capaces de elegir pasos o usar herramientas. También produce código a una velocidad que puede superar el tiempo y la atención disponibles para entenderlo.
La conclusión práctica es incómoda: cambiar de modelo, mejorar la búsqueda o adoptar un flujo dirigido por especificaciones puede reducir una deuda y crear otra. Un sistema mantenible responde cuatro preguntas: qué cambió, qué depende de ello, cómo se comprueba y cómo se revierte o repara.
Una señal de deuda grave es que el equipo ya no pueda rastrear, comprobar o revertir un cambio del sistema.
Un ejemplo ayuda a fijar el problema. Pensemos en un LMS multiinquilino que recupera contenido semánticamente. El contenido de un curso puede viajar por un índice, una caché y una respuesta generada, mientras que la identidad del estudiante, el estado de la matrícula y sus permisos viven en otros sistemas. Si se revoca un documento y la caché no incorpora el inquilino, la identidad y la versión de la fuente en su clave, una respuesta antigua puede reaparecer para la persona equivocada. No hace falta relacionar este ejemplo con un incidente concreto para ver la decisión de arquitectura: el contenido y la autorización no son el mismo dato y no deben gobernarse como si lo fueran.
Este artículo parte de un diagnóstico publicado en 2015 para construir un marco actual. El artículo de Sculley y sus coautores aporta el antecedente y el vocabulario. El objeto del análisis son los sistemas de IA generativa: la generación aumentada por recuperación (RAG), que busca información externa antes de responder; los agentes, que pueden encadenar decisiones o acciones; el código generado; y el desarrollo dirigido por especificaciones (Spec-Driven Development, SDD), que define comportamiento, límites y criterios de aceptación antes de implementar.
La deuda invisible no nació con los modelos de lenguaje
El antecedente más útil para entender el problema es Hidden Technical Debt in Machine Learning Systems. Sculley y otros investigadores de Google lo publicaron en 2015. Su imagen más recordada mostraba el código de aprendizaje automático (Machine Learning, ML) como una caja pequeña dentro de un sistema mucho mayor. Lo decisivo era cambiar la unidad de análisis: un modelo preciso puede formar parte de un producto frágil, caro de modificar y difícil de explicar.
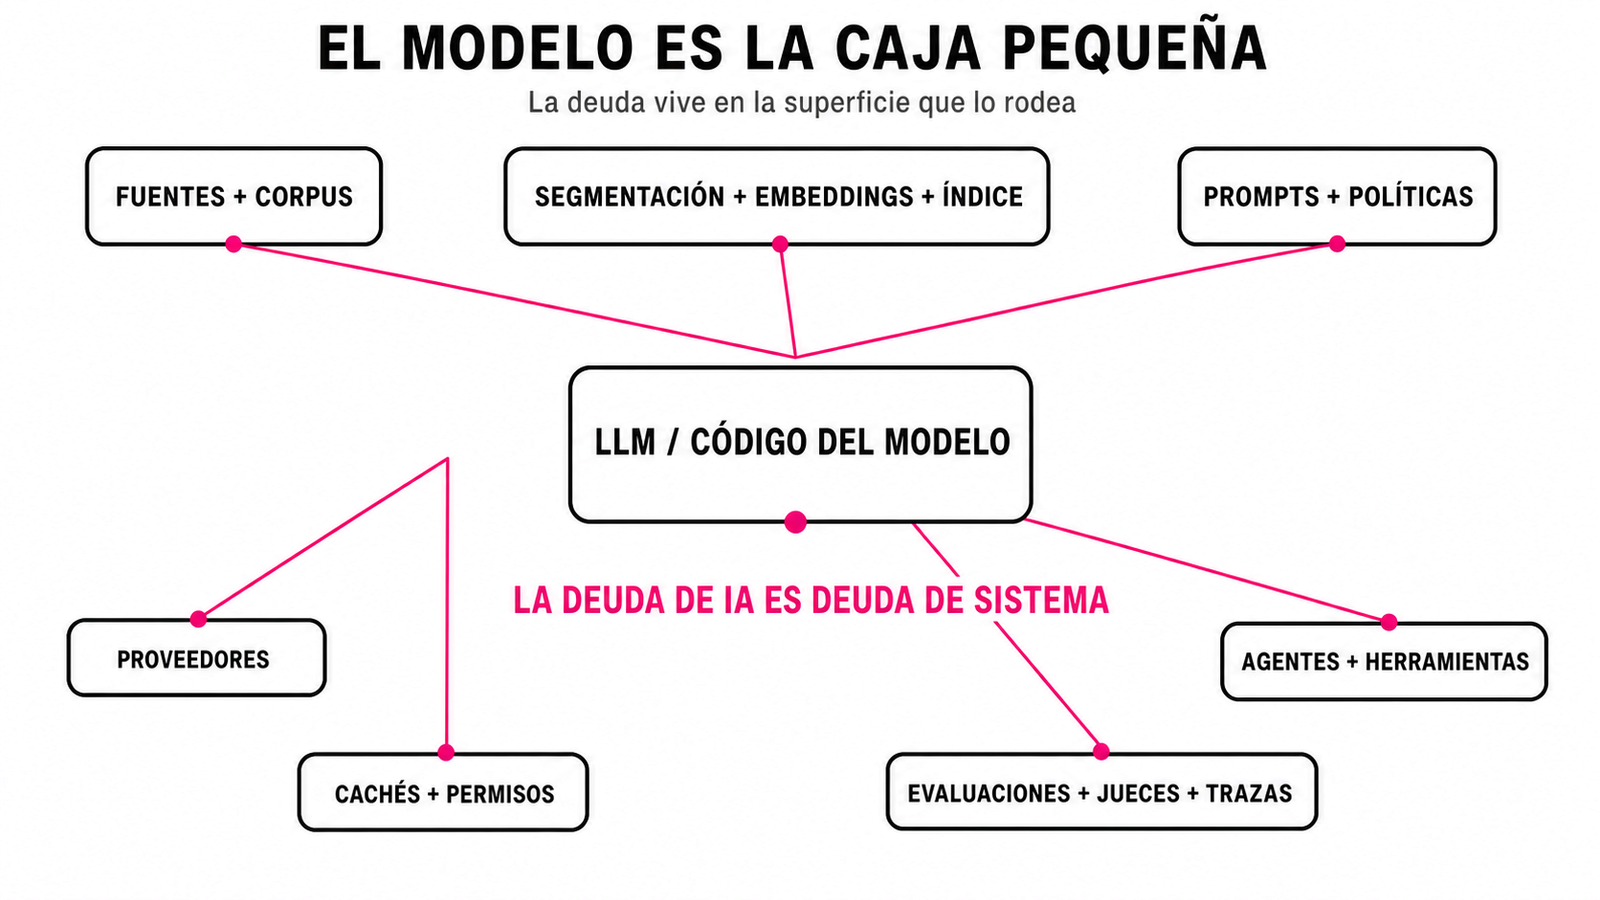
La figura 1 actualiza la imagen de 2015: el modelo sigue siendo una pieza pequeña frente al sistema que lo hace útil y gobernable.
El trabajo describía deudas que el código fuente no revela. Un dato puede conservar su tipo y perder su significado; una predicción puede cambiar el comportamiento de los usuarios y, con él, los datos futuros. El principio CACE, «si cambia algo, cambia todo» (Changing Anything Changes Everything), resume ese acoplamiento: modificar una variable, el muestreo o el filtrado puede alterar el comportamiento del sistema completo. El diagnóstico puede condensarse en este mapa:
| Deuda identificada en 2015 | Cómo se manifiesta | Equivalente frecuente en IA generativa |
|---|---|---|
| Acoplamiento y CACE | Una mejora local altera el comportamiento global | Cambiar las representaciones numéricas (embeddings), la segmentación, el modelo o el prompt modifica la respuesta final |
| Cascadas de corrección | Un modelo corrige a otro y hereda sus supuestos | Un agente consume la salida de otro y propaga una clasificación o un plan erróneos |
| Consumidores no declarados | Otros sistemas usan una salida sin contrato ni propietario | Equipos reutilizan un índice, un prompt, una herramienta o una respuesta intermedia sin registrar la dependencia |
| Dependencias de datos inestables | La fuente cambia formato, semántica o distribución | Un conector, una interfaz de programación (API) o un repositorio documental cambia sin activar una reevaluación |
| Variables infrautilizadas | Una señal aporta poco y mantiene una canalización entera | Metadatos, conectores o componentes de recuperación marginales añaden coste y superficie de fallo |
| Código de conexión y marañas de canalizaciones | Adaptadores y programas sueltos acaban dirigiendo la arquitectura | Cadenas improvisadas de ingestión, análisis, indexación, recuperación, llamadas a modelos y posprocesado |
| Configuración y rutas experimentales | Opciones sin validar y experimentos abandonados siguen activos | Prompts, parámetros, modelos alternativos y banderas se copian sin propietario ni fecha de retirada |
| Bucles y deriva | La predicción cambia el mundo que después se observa | Recomendaciones, respuestas y acciones de agentes condicionan el contenido y las señales futuras |
| Deuda cultural | Se premia añadir precisión o funciones, pero no retirar complejidad ni estabilizar el sistema | Se mide cuánto genera la IA y se deja fuera el coste de revisar, comprender, operar y eliminar |
Dos criterios del artículo siguen siendo especialmente prácticos. Una capa de corrección puede resolver un fallo y crear, a la vez, una dependencia de la siguiente capa. Y una señal marginal puede exigir permisos, validaciones y monitorización durante años. Por eso cada dependencia debería superar una prueba de eliminación: qué métricas empeoran al retirarla y qué complejidad desaparece.
El artículo también identificaba una deuda cultural. Aparece cuando los incentivos premian añadir variables y mejorar métricas, mientras que retirar funciones, mejorar la reproducibilidad, estabilizar la operación o ampliar la monitorización reciben menos reconocimiento. En IA generativa reaparece si se cuenta el volumen producido y se omite el trabajo de revisión y retirada. Ningún registro de deuda compensa que el equipo carezca de tiempo o autoridad para eliminar una dependencia. Por eso la retirada necesita capacidad reservada, un propietario con autoridad para ejecutarla y un criterio visible para reconocerla en la planificación y en las revisiones de operación. El registro documenta la decisión; no crea por sí solo presupuesto ni permiso para tomarla.
El factor temporal completa el diagnóstico. Un cambio en la distribución de las entradas suele describirse como deriva de datos; un cambio en la relación entre entradas y resultados, como deriva de concepto. En sistemas con bucles de realimentación, las predicciones pueden modificar además las señales que se observarán después. Vigilar el procesador, la memoria o los errores del servidor no detecta que una señal ha perdido su significado. Los trabajos posteriores convirtieron parte de aquel diagnóstico en pruebas sobre datos, modelos, infraestructura y monitorización. La enseñanza que resulta útil aquí precede a cualquier herramienta para operar modelos: la deuda de IA es deuda de sistema.
Qué cambia con la IA generativa
La IA generativa conserva aquellas deudas y amplía su alcance. No inventa los principios de operación fiable; concentra más componentes cuyo comportamiento es probabilístico. También hace habitual que una salida textual proponga consultas, planes o acciones que el sistema debe validar y autorizar antes de ejecutar. Cuando el modelo se consume como servicio gestionado, el sistema incorpora una dependencia externa: el proveedor puede cambiar la versión, el precio, la latencia, la ventana de contexto o el comportamiento. El sistema añade instrucciones, ejemplos, políticas, componentes de recuperación, herramientas y verificadores.
También cambia la relación entre producción y revisión. La IA puede reducir el coste marginal de proponer otra implementación, otro conector o una variante de prompt; sigue siendo necesario comprenderla, compararla, integrarla, asegurarla y mantenerla. Cuando generar otra versión tarda menos que revisarla con garantías, el cuello de botella pasa a la aceptación del cambio. Este desfase facilita acumular deuda antes de que el equipo reconozca que ha aumentado el número de activos bajo su responsabilidad.
En la práctica, la IA amplifica las fortalezas y las debilidades del sistema de entrega. Preguntar si «aumenta la productividad» en abstracto oculta esa diferencia. Un equipo con contratos, pruebas, revisión y facilidad de reversión puede convertir la generación rápida en ciclos de aprendizaje más cortos. Sin esos controles, la mayor velocidad amplifica la incertidumbre y traslada más trabajo a la revisión.
La gobernanza debe crecer con el riesgo
No trataría un asistente para generar ideas igual que un agente que hace reembolsos. Clasificaría cada recorrido —no solo la aplicación completa— por cuatro preguntas: ¿qué daño puede causar?, ¿qué datos y personas quedan expuestos?, ¿se puede deshacer el efecto? y ¿cuántos usuarios, inquilinos o sistemas alcanzaría un fallo? La clasificación es una decisión de diseño, no una categoría legal inmutable; debe revisarse cuando el sistema gana permisos, usuarios o efectos secundarios.
| Nivel | Ejemplo | Profundidad razonable |
|---|---|---|
| Exploración o bajo riesgo | Generación de ideas, creación de maquetas o asistente interno sin acceso de escritura | Versionar modelo y prompt, conservar un conjunto pequeño de casos de prueba, evitar datos sensibles y poder desactivar la ruta |
| Asesoramiento o riesgo medio | RAG para documentación interna, resúmenes o recomendaciones que una persona revisa | Añadir control de acceso a la recuperación, abstención, evaluación versionada, muestreo de trazas y reversión sencilla |
| Acción o alto riesgo | Reembolsos, correo externo, SQL de escritura, decisiones sobre datos sensibles o efectos multiinquilino | Añadir autorización en el sistema de destino, idempotencia, confirmación, trazabilidad acotada, pruebas bloqueantes y parada o compensación ensayadas |
La figura 2 resume la regla: cada nivel conserva los controles del anterior y añade los que exige su exposición.
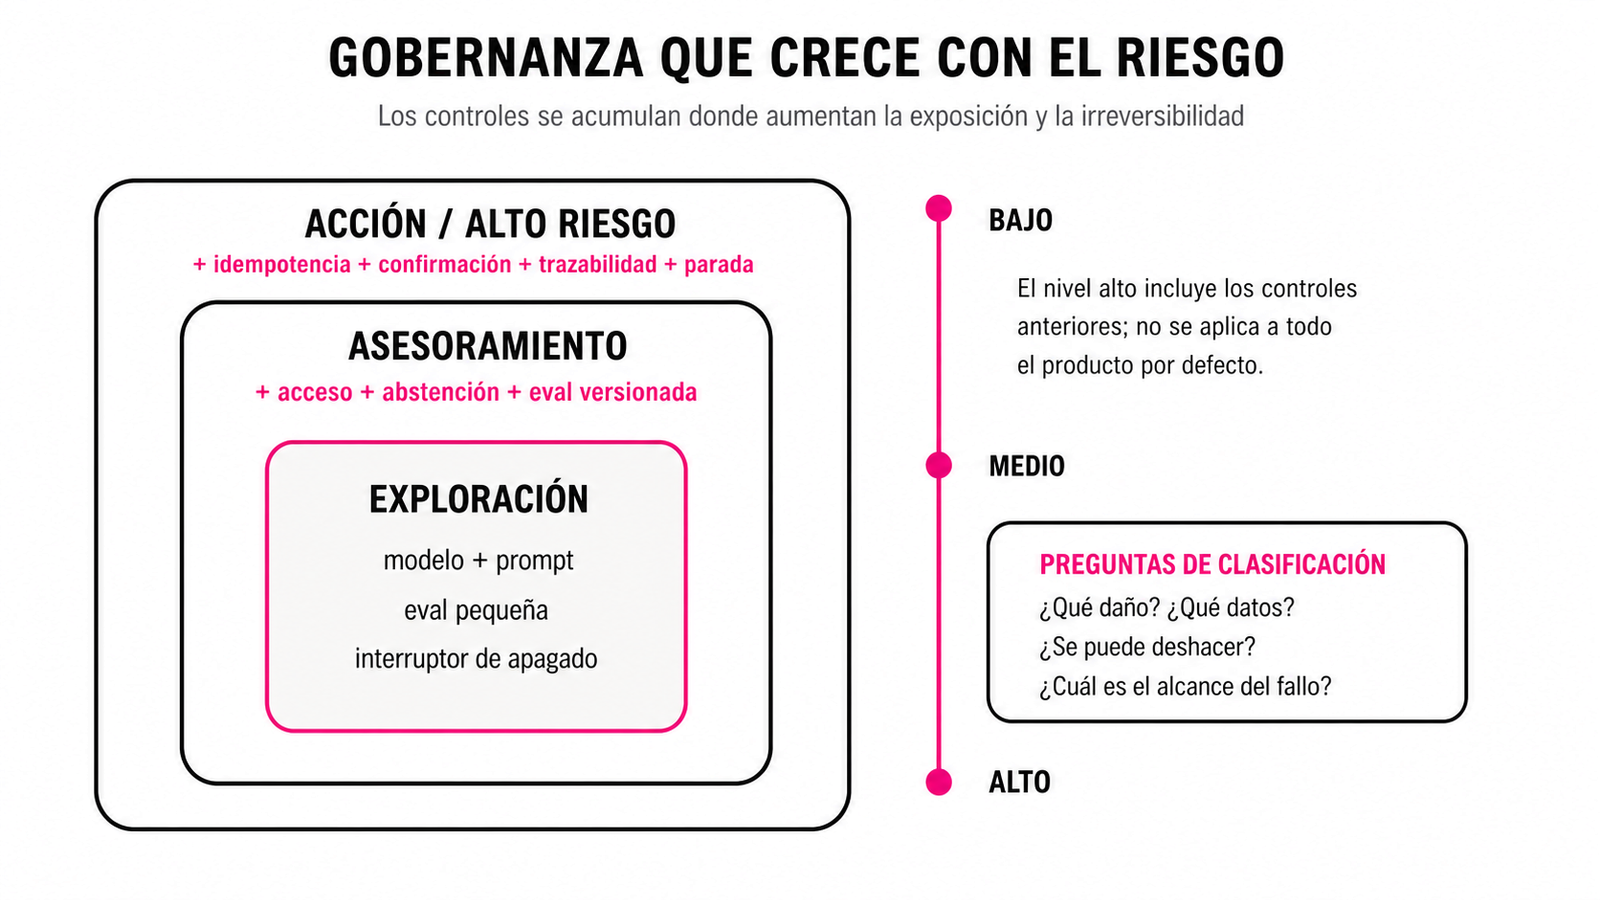
La tabla no propone tres arquitecturas ni una burocracia mínima universal. Un recorrido de bajo riesgo puede necesitar diez casos de evaluación y una bandera de apagado; uno con efectos irreversibles necesita controles más caros porque el coste de fallar es distinto. Si una misma aplicación contiene los tres caminos, no aplicaría el nivel alto a todo: aislaría las capacidades y elevaría el control solo donde cambian la exposición o la irreversibilidad.
El inventario también debe crecer con ese nivel. Siempre versionaría el modelo y el proveedor, las instrucciones, el código y la configuración efectiva, además del conjunto de evaluación que justifica el uso. Cuando haya RAG, añadiría el corpus, el analizador, la segmentación, los embeddings, el índice y las políticas de caché. Cuando haya acciones o datos sensibles, añadiría las herramientas, los permisos, las claves de idempotencia, la política de trazas y el procedimiento de parada. El modelo afinado o destilado requiere además el modelo base, los datos, los filtros y el procedimiento de entrenamiento.
Versionar ayuda a reconstruir una decisión durante la vida operativa del sistema. Si la traza contiene datos personales, el sistema que la conserva debe aplicar un control de acceso específico y conservarla solo durante el plazo necesario. Cuando exista una obligación aplicable de supresión, el cambio debe propagarse a índices, cachés y destinatarios en los términos de los artículos 5, 17 y 19 del Reglamento General de Protección de Datos (RGPD); no debe presuponerse que todos los artefactos se borran automáticamente.
También probaría la sustitución de cada proveedor externo. Para modelos o rerankers sin estado, ejecutaría una muestra versionada por una ruta alternativa o degradada. Compararía sus resultados con la ruta principal en calidad, coste, latencia y proporción de casos derivados a revisión. Si el servicio conserva datos o efectos pendientes, el plan de sustitución debe decidir qué estado puede exportarse, qué operaciones deben continuarse o compensarse y cómo se revocarán los accesos. Sin ese ensayo, el componente puede estar bien trazado y seguir sin ser reemplazable.
En RAG, la fuente es canónica y la recuperación es derivada
Un pipeline de RAG con un índice persistente parece lineal cuando se dibuja deprisa: cargar documentos, crear embeddings, buscar fragmentos y pedir una respuesta al modelo. En producción es una cadena de decisiones. El contenido procede de una fuente local o se incorpora mediante un conector; un analizador conserva o pierde estructura; una estrategia divide el texto; los metadatos habilitan filtros; el modelo de embeddings define un espacio; el componente de recuperación selecciona candidatos; un reranker puede cambiar su prioridad; y el prompt determina cómo usa el modelo esos fragmentos.
CACE reaparece con toda claridad. Cambiar la segmentación altera las unidades
que se pueden recuperar. Cambiar el modelo de embeddings modifica las
distancias. Añadir un filtro puede mejorar la precisión y excluir la única
evidencia válida. Aumentar top-k, el número máximo de fragmentos recuperados,
puede mejorar la cobertura; también puede introducir versiones contradictorias
que empeoran la generación.
Por eso distinguiría dos capas:
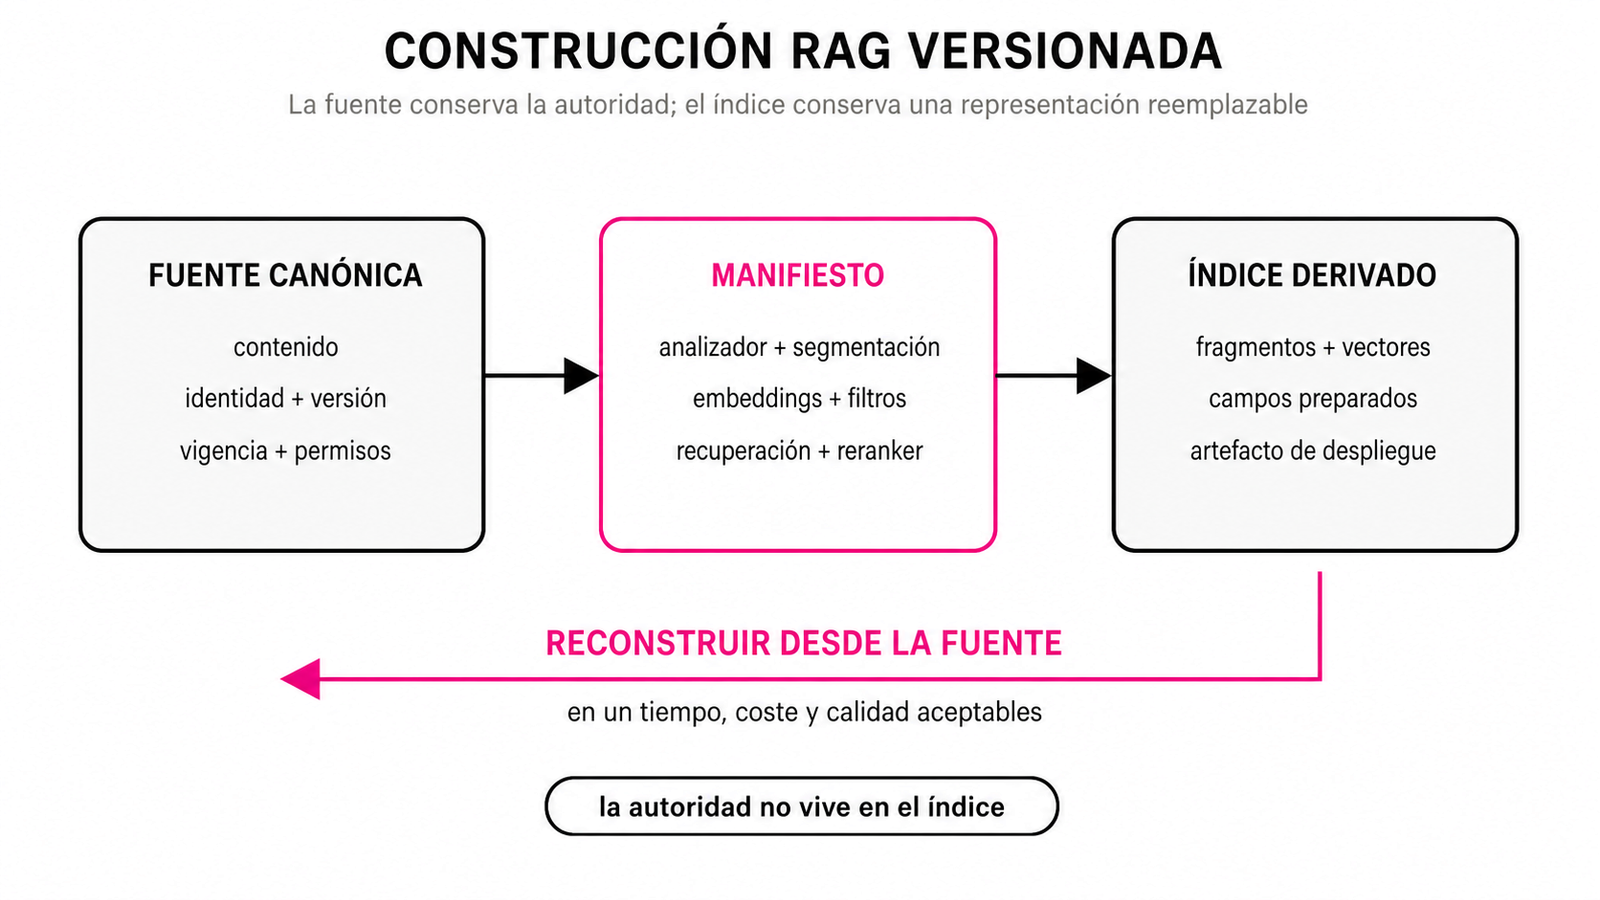
- La fuente canónica con gobierno definido. Conserva el contenido o el mecanismo para volver a obtenerlo, junto con identidad, procedencia, versión, vigencia, ámbito, permisos y política de retención.
- El índice derivado. Contiene fragmentos, vectores y campos preparados para una estrategia concreta de recuperación. Debe ser reemplazable y poder reconstruirse desde la fuente durante su vida operativa.
En sistemas que recuperan mediante búsqueda léxica, consultas estructuradas o API sin un índice persistente, el mismo criterio se aplica a los artefactos de recuperación. Consultas, filtros, versiones de conectores y respuestas deben poder rastrearse sin convertirlos en la fuente canónica.
El mismo principio se aplica a un modelo afinado o destilado, a un reranker o a cualquier otro artefacto derivado. Para reconstruirlo no basta con conservar su nombre: hacen falta la versión del modelo base, los datos y filtros de entrenamiento, la receta, los parámetros, la semilla cuando sea relevante, los pesos publicados y la evaluación. La reconstruibilidad tampoco es binaria: debe expresarse como un tiempo, un coste y una calidad mínima aceptables.
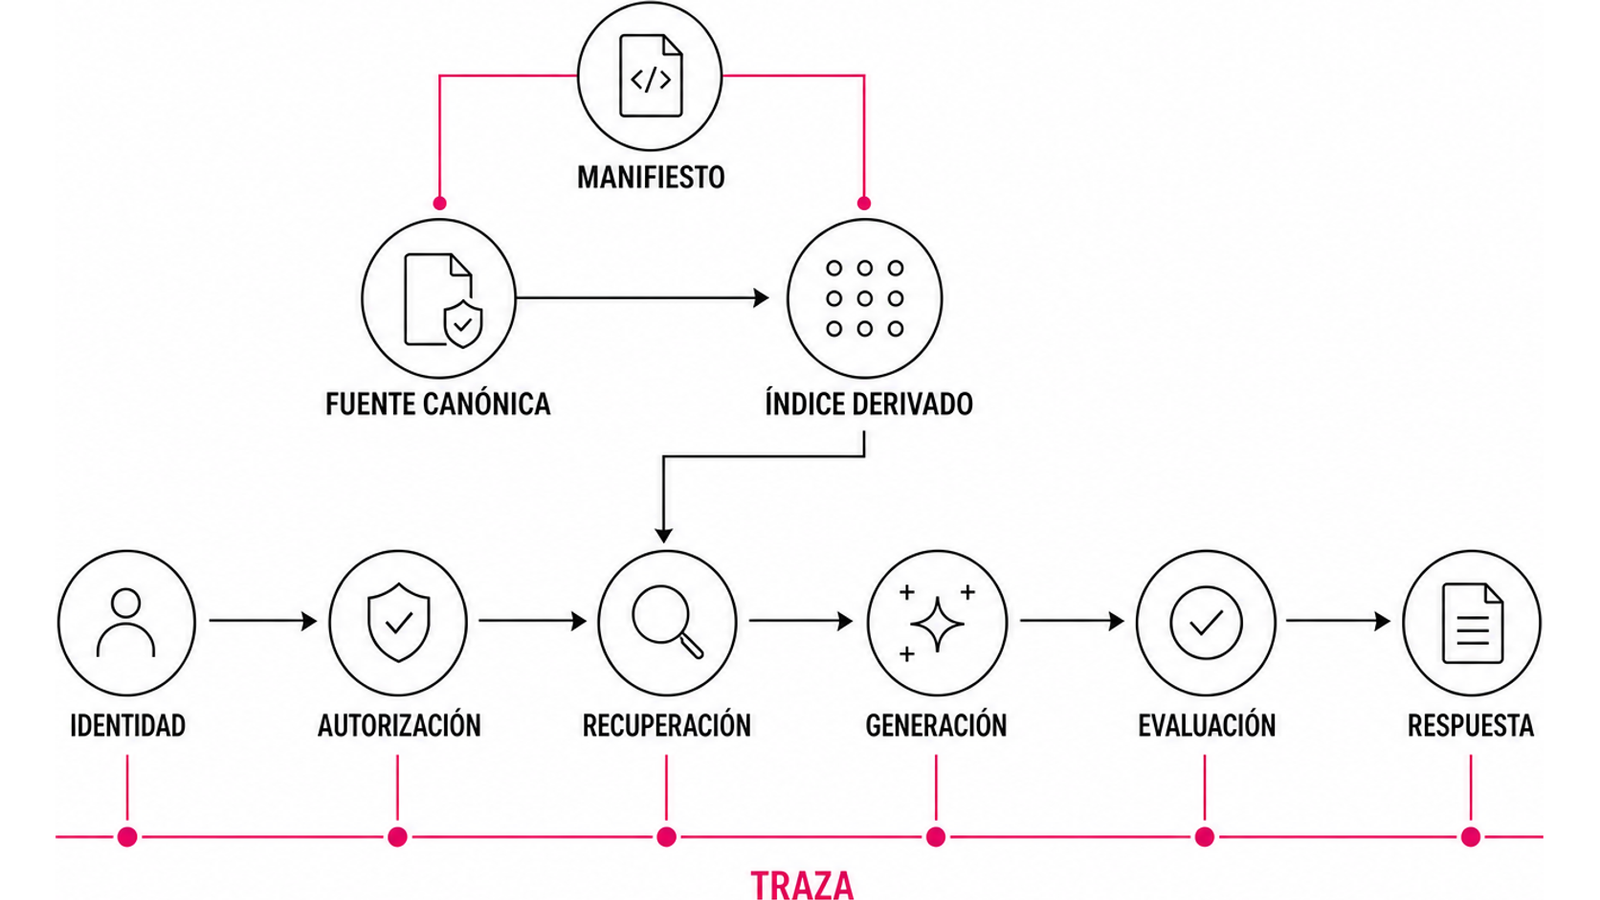
La figura 3 muestra el proceso de construcción; el diagrama de consulta que aparece más adelante muestra el otro tramo. Juntos forman el ciclo de vida que el índice debe poder recorrer sin convertirse en la referencia canónica.
Los permisos de la fuente deben propagarse a los fragmentos. Copiar la lista de acceso resulta insuficiente. Para recursos no públicos, la autorización debe resolverse antes de exponer candidatos al reranker, al modelo o a un servicio externo. La consulta debe filtrar por identidad, recurso, ámbito, finalidad y vigencia dentro de la misma frontera de confianza. Si el motor no permite garantizarlo, la ruta debe abstenerse o usar una alternativa segura; no debe enviar candidatos sin autorizar para filtrarlos más tarde.
Esta decisión tiene un coste. En índices de vecinos aproximados, un filtro selectivo puede reducir la cobertura o forzar una búsqueda más exhaustiva. Las alternativas —aceptar menos cobertura, asumir más latencia o particionar el índice por inquilino— añaden riesgos y mantenimiento distintos. La evaluación debe medir cobertura, latencia, coste y aislamiento por segmento. El ejemplo del LMS vuelve aquí: la caché no puede tratar una respuesta autorizada como si fuera contenido público.
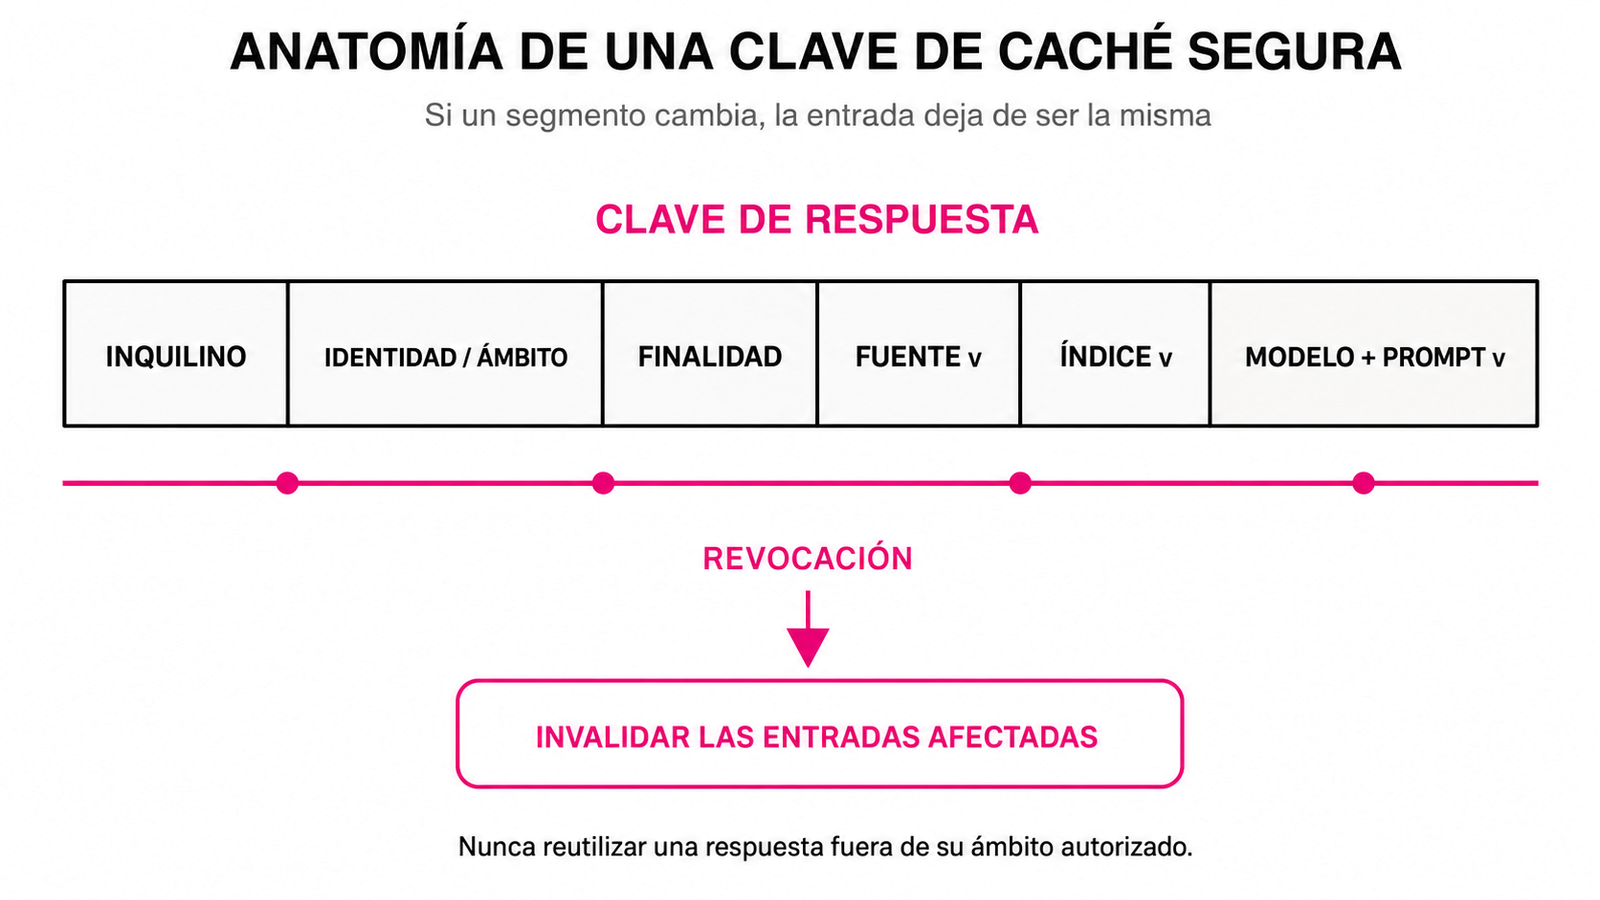
La clave de una caché de respuestas multiinquilino debe incluir, como mínimo, el inquilino, la identidad o el ámbito autorizado, la finalidad, la versión de la fuente y las versiones del índice, el modelo y el prompt. Una revocación debe invalidar las entradas afectadas; una caché que ignore esos campos puede servir a una persona una respuesta calculada para otra.
La figura 4 convierte esa regla en una clave que se puede revisar segmento a segmento y cuya invalidación deja de ser implícita.
«Canónica» describe el lugar donde se gobiernan el estado, la autoridad y los cambios de cada documento; no garantiza que sea verdadero ni inmutable. Si cambia el criterio de segmentación o el modelo de embeddings, el índice anterior deja de representar esa versión del sistema y debe reconstruirse antes de ponerla en servicio. Sin una fuente con gobierno definido que conserve el contenido o garantice la recuperación de la misma versión del corpus y sus metadatos, no puede reconstruirse ese corpus. Cuando existe dicha fuente, el índice es un artefacto de despliegue, no el único lugar donde sobrevive el conocimiento.
Un manifiesto de construcción debería recoger, como mínimo, la versión del corpus y del analizador, las reglas de normalización, la segmentación, los embeddings, los metadatos, los filtros, el componente de recuperación, el reranker y la fecha de creación. La traza asociada a la respuesta debe incluir una huella de ese manifiesto. Para reconstruir una ejecución, la traza relaciona esa huella con el despliegue y la consulta efectiva. También identifica filtros, parámetros, fragmentos con sus versiones y metadatos del proveedor. Esta evidencia no garantiza reproducir literalmente una salida generativa, especialmente cuando el proveedor no ofrece una versión fijable o el modelo es no determinista.
No construiría toda esta telemetría desde cero si el sistema puede adoptar una convención existente. OpenTelemetry mantiene convenciones semánticas para trazas y operaciones de IA generativa, que reducen el código de integración y facilitan correlacionar llamadas al modelo, recuperación y herramientas. No resuelven por sí solas la privacidad: los propios atributos de entrada y salida pueden contener datos personales. Un procesador de tramos (span processor) puede filtrar, ocultar o tokenizar NIF, correos y nombres antes de que el exportador envíe la traza al backend; hashearlos no los convierte automáticamente en datos anónimos. Siguen haciendo falta muestreo, minimización, retención, control de acceso y un límite de cardinalidad y coste.
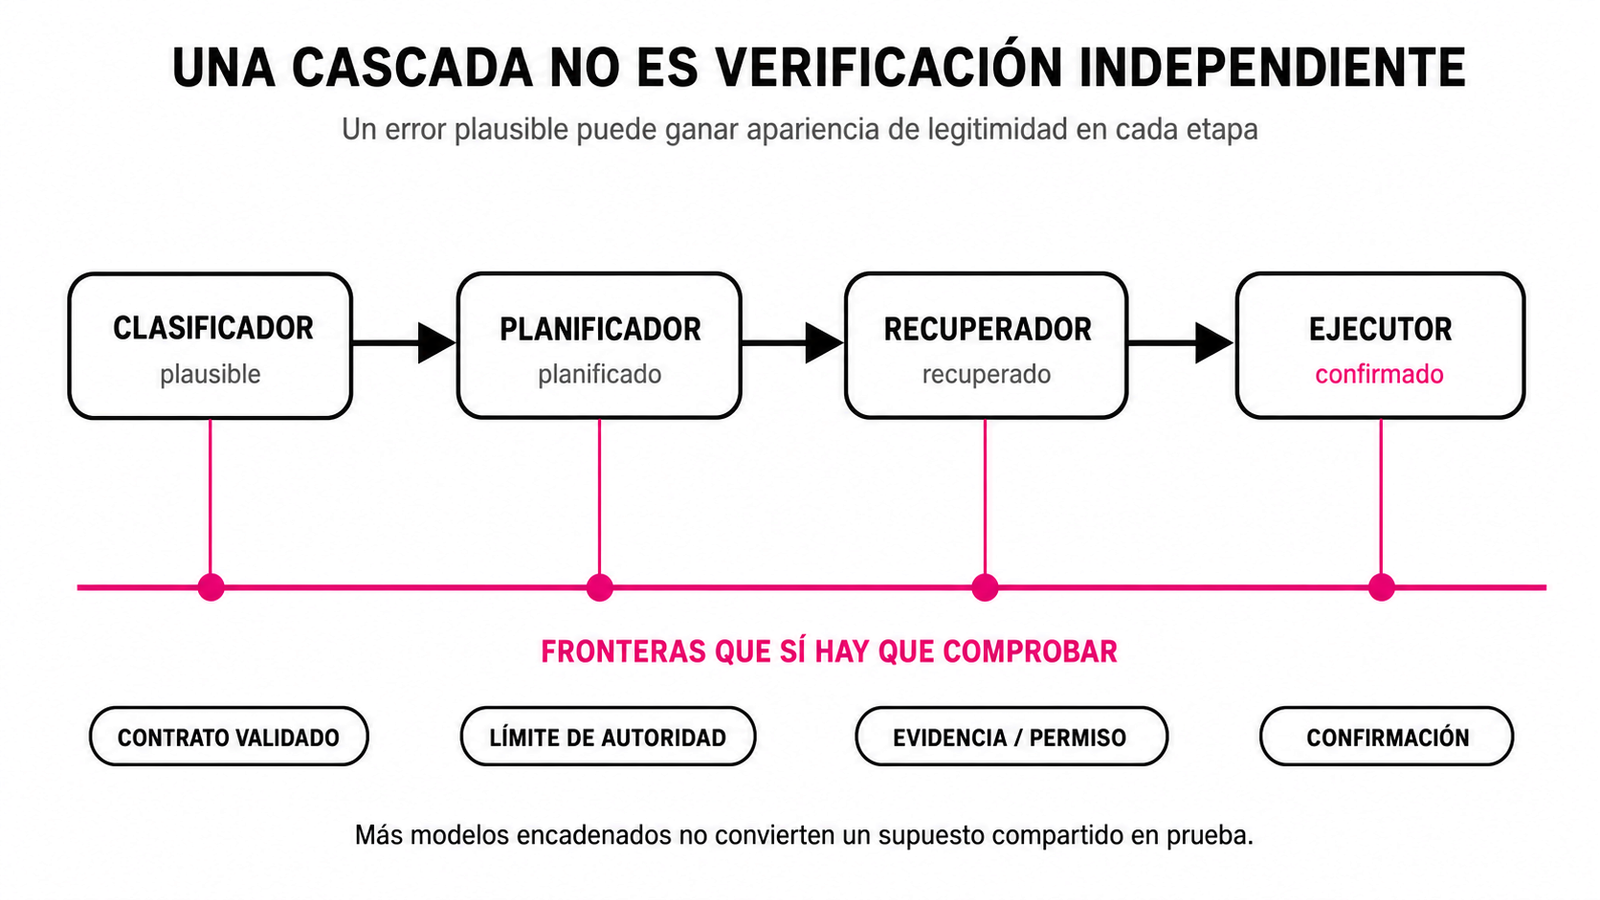
Los agentes añaden cascadas. Si un primer agente clasifica la consulta, un segundo diseña un plan, un tercero recupera y un cuarto ejecuta una acción, la salida de cada uno se convierte en dato de entrada del siguiente. Un error plausible al principio puede llegar al final con apariencia de decisión confirmada. Cada frontera necesita contrato, validación y un límite de autoridad; encadenar más modelos no constituye una verificación independiente.
La figura 5 muestra por qué la plausibilidad acumulada no equivale a una verificación independiente: cada frontera necesita su propia evidencia y su propio límite de autoridad.
En integraciones con una plataforma de gestión del aprendizaje (LMS), esta separación es decisiva. El contenido admite búsqueda semántica, pero el estado actual, la identidad y las reglas de acceso no deberían convertirse sin más en fragmentos. Relevancia, autoridad, vigencia y permiso son decisiones diferentes. El ejemplo anterior no describe un incidente concreto: muestra por qué la autorización, la caché y la recuperación deben diseñarse juntas.
Mitigar la deuda de RAG exige reconstruir las evidencias y rastrear cada respuesta
No existe una configuración universal para reducir la deuda de RAG. Hay un conjunto de controles que ayuda a localizar el fallo, estimar el coste recurrente que genera y revertir el cambio responsable. Cada control es también una dependencia: necesita propietario, mantenimiento, presupuesto de atención y una prueba de retirada.
| Control | Señal que detecta | Medida útil | Decisión que habilita |
|---|---|---|---|
| Contrato de fuente | Cambios de formato, autoridad, vigencia o permisos | Incidencias por fuente, retraso de actualización y pruebas de revocación | Pausar un conector, excluir una versión o reindexar |
| Manifiesto del índice | No se puede reconstruir el artefacto indexado | Cobertura de índices cuyo manifiesto identifica corpus, analizador, segmentación, embeddings, metadatos y despliegue | Reconstruir, comparar o revertir un índice |
| Traza de recuperación con retención mínima | No se puede reconstruir qué evidencia se entregó al modelo para generar una respuesta | Cobertura de respuestas con manifiesto, consulta, filtros, parámetros, candidatos aceptados y descartados, versiones y plazo de retención | Reconstruir la recuperación y acotar la hipótesis del fallo |
| Evaluación separada | La puntuación final baja sin indicar el componente | Precisión y cobertura de la recuperación; fidelidad y relevancia de la respuesta | Corregir ingestión, recuperación o generación |
| Corpus adversarial | El sistema solo se prueba con preguntas fáciles | Rendimiento por segmento, conflictos, negativos y preguntas sin respuesta | Ajustar umbrales y política de abstención |
| Despliegue gradual | Una nueva versión sustituye a la anterior de una vez | Diferencia en las métricas de aceptación, el coste y la latencia frente al control | Promover, detener o revertir |
| Presupuesto de dependencias | Cada mejora añade otro servicio permanente | Ganancia marginal frente a coste, fallos y mantenimiento | Retirar conectores, rerankers o rutas experimentales |
Evaluar por separado la recuperación y la generación permite localizar dónde apareció el fallo y reduce el riesgo de intervenir sobre el componente equivocado. La separación solo resulta útil si el corpus de prueba y las métricas representan las consultas que el sistema recibirá en producción. El propio evaluador también acumula deuda. El conjunto de referencia puede quedar obsoleto, el juez puede cambiar de versión y un LLM-as-judge puede mover la línea base sin que haya mejorado el sistema. Versionaría el corpus, la rúbrica, el prompt del juez, el modelo y su proveedor; conservaría casos ancla para calibrarlo; registraría desacuerdos con evaluadores humanos y fijaría una fecha de revisión. Un juez probabilístico no debería ser el único control para una decisión de alto impacto.
Una tríada útil, formada por la cobertura de la recuperación, la fidelidad y la relevancia de la respuesta, es un buen comienzo, no un cuadro de mando completo. Separaría la precisión de la recuperación —qué proporción de los candidatos recuperados es relevante— de su cobertura —qué proporción de las evidencias relevantes necesarias se ha recuperado—. Añadiría vigencia, autorización, resolución de conflictos y acierto al abstenerse. Tampoco hablaría de una única «tasa de alucinación»: mezcla fallos de cobertura, evidencia, utilización y seguridad que requieren responsables distintos.
La búsqueda híbrida combina coincidencias de palabras con proximidad semántica. Un reranker vuelve a ordenar los candidatos mediante una regla de fusión o un segundo modelo. Según la técnica, añade cómputo, parámetros, latencia o proveedores. Ambas opciones pueden mejorar un caso concreto y también introducir modos de fallo. Los incorporaría solo si, en una evaluación versionada, la mejora alcanza el umbral fijado antes de la prueba en los segmentos que justificaron el cambio, sin rebasar los límites de coste, latencia o seguridad. Si no, son nueva deuda presentada como sofisticación.
También existen optimizadores que ajustan prompts, ejemplos o pesos a partir de una métrica, como los documentados por DSPy. Pueden reducir trabajo manual y descubrir configuraciones mejores, pero no eliminan CACE: el optimizador, sus datos, la métrica, el prompt o los pesos resultantes pasan a ser nuevos artefactos versionables y pueden sobreajustarse al conjunto de evaluación. Del mismo modo, GraphRAG puede ayudar con preguntas relacionales o globales, pero añade extracción, resúmenes e índices propios; no sustituye la autorización, la evaluación ni la posibilidad de reconstruir y retirar esos artefactos.
La evaluación debe entrar en el ciclo de entrega. Cada cambio de fuente, analizador, segmentación, embeddings, componente de recuperación, reranker, prompt o modelo debe activar las pruebas correspondientes. Los de mayor riesgo se prueban en modo sombra, sin mostrar sus resultados a los usuarios, o se despliegan de forma gradual. Una prueba de revocación fija un plazo acordado y comprueba, dentro de ese plazo, que la persona o el servicio afectados dejan de recuperar el recurso desde índices y cachés. El acceso se mantiene para quienes siguen autorizados. La reversión incluye el índice, la configuración y el código.
Los agentes necesitan límites para actuar, no solo para responder
Un agente no se limita a redactar. Puede consultar herramientas, encadenar decisiones y modificar sistemas externos. Esa diferencia cambia la deuda: una respuesta equivocada puede descartarse; un reembolso efectuado, un mensaje enviado o un registro borrado pueden exigir una reparación y quizá no admitir una reversión completa.
El reembolso duplicado es un incidente. La deuda está en el diseño que permite repetirlo, impide detectarlo o encarece su reparación.
Para contener los reintentos usaría claves de idempotencia. La clave no la inventaría el agente: la derivaría de una identidad de negocio definida fuera del modelo, por ejemplo, la operación, el identificador del pedido, el importe, la moneda y la revisión esperada, serializados de forma canónica. Si la misma operación se repite con los mismos parámetros dentro de la ventana que conserva el ejecutor, el sistema devuelve el resultado anterior sin volver a ejecutar el efecto. Fuera de esa ventana, la clave deja de proteger por sí sola; hace falta consultar el estado de la operación o aplicar una compensación.
No daría a un agente acceso genérico a todas las herramientas disponibles. Cada llamada debe ejecutarse en nombre de una persona o un servicio identificados, con credenciales acotadas, y el sistema de destino debe volver a autorizar la acción, el recurso y la finalidad. El plan del agente no concede permisos. Separaría las consultas de las acciones y reservaría los permisos de escritura para el tramo que realmente los necesita. Ante una autorización dudosa, la ejecución se detiene. Si la herramienta solo ofrece roles amplios, el adaptador debe ser el único camino autorizado: valida una autorización interna acotada, mantiene fuera del alcance del agente la credencial amplia del destino y ejecuta únicamente la operación aprobada. Una credencial efímera solo añade granularidad cuando el destino valida ese ámbito. Si el adaptador puede eludirse o no limita recurso y acción, el agente se limita a preparar una propuesta para un proceso de revisión humana independiente.
| Control | Deuda o riesgo que contiene | Evidencia que debe quedar |
|---|---|---|
| Lista explícita de herramientas y permisos mínimos | El agente descubre funciones o datos fuera de su tarea | Herramienta, identidad, ámbito, tipo e identificador no secreto de la credencial y decisión de autorización |
| Presupuesto de pasos, tiempo y coste | Bucles, reintentos y planes que crecen sin límite | Pasos consumidos, motivo de parada y coste de la ejecución |
| Contrato entre etapas | Una salida plausible se convierte en entrada aceptada | Esquema validado, procedencia y estado de cada transición |
| Separación entre plan y ejecución | Un plan plausible se interpreta como permiso para actuar | Plan propuesto, previsualización y autorización independiente |
| Aprobación antes de efectos de alto impacto | Una inferencia termina en una acción irreversible | Propuesta mostrada, persona o política que autorizó y alcance aprobado |
| Clave de idempotencia estable por operación lógica | Un reintento duplica un cobro, envío o alta | En el almacén de idempotencia del ejecutor: clave estable, parámetros y resultado anterior; en la traza: identificador de correlación no reutilizable y confirmación del destino |
| Confirmación de la operación | El agente afirma haber actuado sin confirmación autorizada | Identificador y estado devueltos por la fuente que ejecutó la operación |
| Acción compensatoria | La operación no admite una reversión literal | Procedimiento de reparación, límites y responsable |
| Interruptor de parada y revocación | El comportamiento incorrecto continúa usando herramientas | Motivo, momento y recursos cuyo acceso se retiró |
La confirmación importa porque el texto del modelo no demuestra que la operación se haya completado. La confirmación debe proceder del sistema que conserva el estado. La idempotencia solo evita duplicar el efecto cuando el sistema que lo ejecuta reconoce la misma clave para la misma operación lógica, comprueba que los parámetros coinciden y conserva el resultado durante la ventana de reintentos. Una clave nueva por intento no impide repetir la operación; tampoco lo hace un registro local creado después del efecto. La idempotencia no vuelve reversible la operación. Cuando una acción no puede deshacerse, esa limitación y su procedimiento de reparación deben conocerse antes de autorizarla.
La clave reutilizable vive en el almacén de idempotencia del sistema que ejecuta el efecto o del proveedor, con acceso restringido. La traza de auditoría conserva un identificador de correlación no reutilizable y la confirmación. La política debe documentar cuánto tiempo se conserva la clave y qué ocurre si una persona o un agente reanuda la tarea después de ese plazo.
La figura 6 separa visualmente las dos rutas: la primera llamada guarda la operación y su resultado; el reintento consulta ese resultado y no vuelve a producir el efecto.
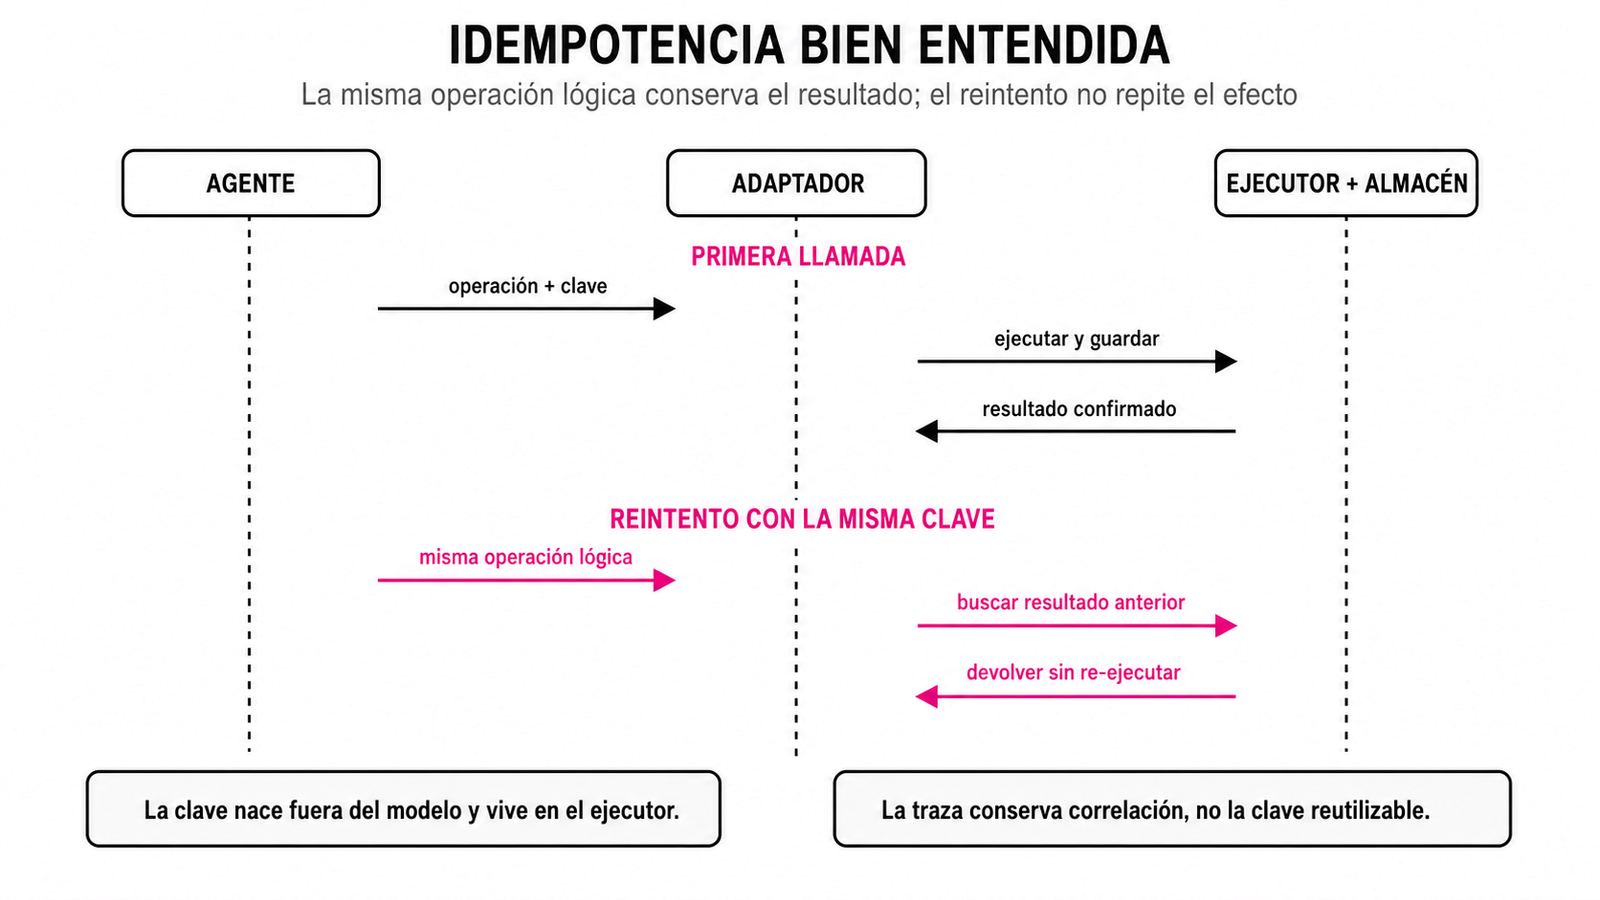
En este diseño, la traza general no conserva credenciales, claves de acceso ni la clave reutilizable de idempotencia. Registra únicamente los metadatos no secretos necesarios para investigar: identidad efectiva, herramienta, acción, recurso, ámbito, política y decisión de autorización, además del tipo, emisor, caducidad e identificador no secreto de la credencial.
Evaluaría por separado si el plan elige pasos permitidos y si los efectos son correctos. Un agente puede elegir un plan razonable y fallar al ejecutar una herramienta, o completar todos los pasos de un plan que nunca debió aprobarse. La traza debe permitir localizar la frontera defectuosa sin conservar conversaciones, datos personales o credenciales que no hagan falta para investigar.
Para agentes mediría, por herramienta y nivel de riesgo:
- propuestas no autorizadas entre todas las propuestas;
- operaciones sin confirmación entre las operaciones ejecutadas;
- duplicados entre los reintentos;
- compensaciones entre los efectos completados;
- rechazos o modificaciones humanas entre las solicitudes de aprobación.
Para cada medida fijaría la ventana, los segmentos y el umbral antes del despliegue.
El código generado desplaza la deuda hacia comprensión, arquitectura y seguridad
Cuando producir otra versión cuesta menos que revisarla con garantías, la deuda se desplaza hacia la aceptación del cambio. Antes de integrarlo, alguien debe aportar evidencia de que respeta el dominio, reutiliza las abstracciones existentes, cubre los casos límite previstos y ha superado controles de seguridad proporcionales al riesgo. El riesgo residual debe quedar identificado y aceptado por quien corresponda, y el código debe poder mantenerse sin depender del contexto privado que lo originó.
El uso ad hoc de prompts favorece soluciones locales. «Añade una ruta al servicio» no explica a qué capa corresponde la operación ni qué autorización se aplica. Tampoco indica el contrato de errores, la biblioteca interna que registra la operación o los contratos que deben seguir siendo compatibles con sus consumidores. El modelo completa los huecos con patrones plausibles. Dos peticiones parecidas pueden introducir dos maneras de validar, registrar o transformar lo mismo.
La información parcial sobre el repositorio favorece la reinvención de la rueda, pero el acceso masivo tampoco garantiza coherencia. Un agente puede leer una utilidad y no saber que debe usarla, o encontrar tres implementaciones y elegir la que el equipo intenta retirar. La arquitectura necesita reglas explícitas y verificables: dependencias permitidas, capas, propietarios, contratos y excepciones fechadas.
La deuda de comprensión aparece cuando el equipo aprueba el resultado y es incapaz de explicar sus invariantes o modificarlo con seguridad. Esto conecta con una distinción que ya planteé al analizar cómo medir la productividad del desarrollo con IA: la unidad útil es el cambio validado y estable, con la revisión y el trabajo rehecho incluidos.
Los problemas observados alrededor del código asistido por modelos no forman una deuda nueva y aislada. Reaparecen en el diseño, los defectos, la documentación, los requisitos y las pruebas; la comprensión limitada atraviesa todas esas categorías. La evidencia tampoco permite resumir el efecto en una única cifra. En un ensayo aleatorizado de METR, 16 desarrolladores experimentados completaron 246 tareas y tardaron un 19 % más con las herramientas de IA de principios de 2025; el resultado describe ese contexto, no todo el desarrollo de software. La propia organización advirtió en febrero de 2026 de que su siguiente medición estaba sesgada por selección de participantes y tareas, por lo que la consideró una señal poco fiable. Resultados iniciales de METR y revisión del diseño experimental.
La lectura más prudente coincide con el análisis de DORA de 2026: la adopción puede asociarse a más capacidad de entrega y, al mismo tiempo, a más inestabilidad. La medida útil sigue siendo el cambio validado y estable, no el volumen producido. DORA sobre las tensiones de la IA en el ciclo de desarrollo
Seguridad del código, la aplicación y el entorno
Las vulnerabilidades introducidas en el código generado se revisan con los controles habituales de ingeniería: modelado de amenazas, revisión, pruebas, análisis estático, análisis de dependencias y detección de secretos. Que el código proceda de un modelo no cambia las categorías de vulnerabilidad ni rebaja el nivel de comprobación exigible.
La aplicación que incorpora un modelo de lenguaje abre otra superficie de riesgo: inyección de instrucciones, uso inseguro de salidas, acceso excesivo a herramientas, filtración de información o debilidades en vectores y embeddings. Un equipo necesita ambos mapas. Aplicar los riesgos propios de una aplicación generativa al código generado deja fuera vulnerabilidades convencionales; aplicar solo el primero ignora que un texto que no es de confianza puede alterar el comportamiento del sistema.
Hay un tercer plano: el agente y el entorno desde el que se modifica el software. El acceso al repositorio, la red, los secretos, el gestor de paquetes y la integración continua (CI) deben quedar aislados y sujetos a permisos mínimos. El contenido del repositorio también puede incluir instrucciones maliciosas; una nueva dependencia o un cambio en CI no deberían aprobarse solo porque formen parte del parche generado. Los marcos específicos para agentes ayudan a ordenar este tercer plano, pero no sustituyen los controles de ingeniería del repositorio ni los permisos del sistema de destino.
SDD puede adelantar controles antes de integrar el código generado
RAG, agentes y código generado acumulan deuda durante el diseño y la operación. El desarrollo dirigido por especificaciones, o SDD por sus siglas en inglés, parte de una especificación persistente, la spec. Esta describe el comportamiento, los límites, las interfaces y los criterios de aceptación antes de integrar el código. La arquitectura sigue siendo una decisión humana: una spec no la sustituye. No la trataría como un documento cerrado que haya que completar antes de explorar. Durante el descubrimiento puede registrar hipótesis pequeñas y reversibles; gana precisión cuando el límite del componente, el contrato o el riesgo justifican mantenerla junto al código y las pruebas.
En el extremo opuesto, la redacción ad hoc de instrucciones (prompting) o el vibe coding consiste en pedir cambios mediante conversaciones informales y aceptar la solución a medida que parece funcionar, sin un contrato previo suficientemente preciso. Organizo la respuesta en cinco bloques: cuatro mecanismos con los que SDD reduce esa improvisación y un quinto, complementario, de evaluación continua del comportamiento probabilístico. Su efecto debe medirse en cada contexto: una especificación no demuestra que las decisiones sean correctas ni que vayan a disminuir los defectos.
1. Un marco persistente de decisiones
Antes de generar código, la especificación fija propósito, alcance, tipos, estados, errores, contratos y decisiones de integración. Puede combinar texto estructurado en Markdown con contratos que una máquina pueda validar: OpenAPI para interfaces, JSON Schema para estructuras de datos o bibliotecas de validación de modelos como Pydantic y Zod. El formato depende de lo que deba comprobarse.
La especificación actúa como contrato versionado de decisiones y límites: reduce lo que el modelo tiene que adivinar y conserva decisiones entre sesiones. Para prevenir duplicación debe enumerar los módulos internos, servicios compartidos y bibliotecas obligatorias o permitidas. Para proteger la arquitectura debe declarar también dependencias prohibidas y excepciones.
Su efecto tiene un límite claro. Si la arquitectura no está decidida, la spec solo documentará una ambigüedad o esconderá una decisión improvisada con más formalidad.
2. Verificación determinista del cumplimiento
Los criterios de aceptación y los contratos dan pie a controles automáticos: formato, análisis de estilo y errores, tipos, validación de esquemas, pruebas unitarias, de contrato y de integración, y reglas arquitectónicas. Si cada criterio se vincula a una comprobación ejecutable y obligatoria, la integración continua puede rechazar las incompatibilidades antes de que lleguen a la rama principal. Para impedir que un fallo llegue a la rama, esa comprobación debe ser obligatoria en la política de integración.
Los invariantes deterministas se comprueban con mecanismos deterministas. Las evaluaciones probabilísticas requieren corpus, jueces, umbrales y versiones explícitos. Una prueba demuestra que el código cumple lo que comprueba; no que la especificación sea correcta ni completa.
Siempre que el riesgo lo justifique, el validador decisivo debería tener un modo de fallo distinto del generador y basarse en una regla determinista, otra implementación, otro conjunto de datos o una revisión humana. Si el mismo modelo deriva la spec, el código y las pruebas, puede reproducir el mismo supuesto equivocado en las tres capas y obtener una falsa sensación de acuerdo. Otra implementación o conjunto de datos puede reducir fallos compartidos, pero no demuestra independencia: versiones desarrolladas por separado han mostrado fallos correlacionados ante las mismas entradas. Estudio de Knight y Leveson sobre fallos correlacionados.
3. Reutilización explícita de la arquitectura existente
Una spec bien conectada al repositorio indica qué abstracciones se reutilizan, dónde se extiende un contrato y qué equipo es responsable de la interfaz. Esto reduce la tentación de crear otra utilidad, otro cliente para servicios web o una nueva representación del mismo estado.
Una instrucción en prosa resulta insuficiente. Las reglas de dependencias, los catálogos de servicios, los analizadores de arquitectura y las pruebas de contrato convierten la intención en una restricción. Si el modelo propone una nueva dependencia, debe justificar qué función falta, qué alternativa se evaluó y cómo se retirará.
4. Código regenerable dentro de límites estables
Cuando un componente está aislado, carece de estado propio y cumple contratos ejecutables, su implementación puede tratarse como reemplazable. Si acumula parches, el equipo ajusta la especificación, regenera una propuesta y la somete a las mismas pruebas. El valor duradero reside en el contrato y en la evidencia, no en cada línea de una implementación concreta. Eso no elimina la necesidad de entender el componente: el equipo debe comprender el contrato, los invariantes, los efectos externos y los modos de fallo de su frontera.
No todo el software es regenerable. Migraciones de datos, efectos secundarios, formatos persistidos, compatibilidad pública, requisitos regulatorios y conocimiento tácito hacen que borrar y regenerar pueda destruir información o repetir errores ya resueltos. La regeneración funciona mejor en adaptadores, transformaciones y componentes acotados detrás de interfaces estables.
Complemento: evaluación continua del comportamiento
Un conjunto de casos de prueba representativos —un golden dataset— puede ser el contrato observable de una respuesta probabilística. No sustituye a los contratos de una API, a la autorización ni a la idempotencia: comprueba el comportamiento que esperamos en ejemplos concretos y deja visibles los casos que todavía no sabemos describir con una regla. Este enfoque se parece a lo que algunos equipos llaman Evals-Driven Development (EDD), pero lo usaría como complemento de SDD, no como su reemplazo: las evaluaciones cubren el comportamiento observado y los contratos fijan los límites que no deben depender de una muestra.
Lo ejecutaría como una pirámide de evaluaciones, no como un juez caro en cada pull request. En la CI del cambio pondría la mayoría de comprobaciones deterministas y baratas: esquemas JSON, contratos, expresiones regulares, presupuestos de latencia y coste y filtros básicos de seguridad. Añadiría un conjunto ancla muy pequeño y cacheado para detectar una regresión evidente. La evaluación amplia con LLM-as-a-judge la ejecutaría de forma asíncrona, por la noche o en una fase previa a promover a producción; solo bloquearía el merge cuando el riesgo y el tiempo de respuesta justifiquen expresamente ese coste. La caché debe invalidarse al cambiar el modelo, el juez, la rúbrica o el caso, y no elimina por completo la variabilidad.
La figura 7 lo resume como una pirámide de varias velocidades: el pull request bloquea lo determinista y barato; la evaluación probabilística amplia se ejecuta con más contexto y otra cadencia.
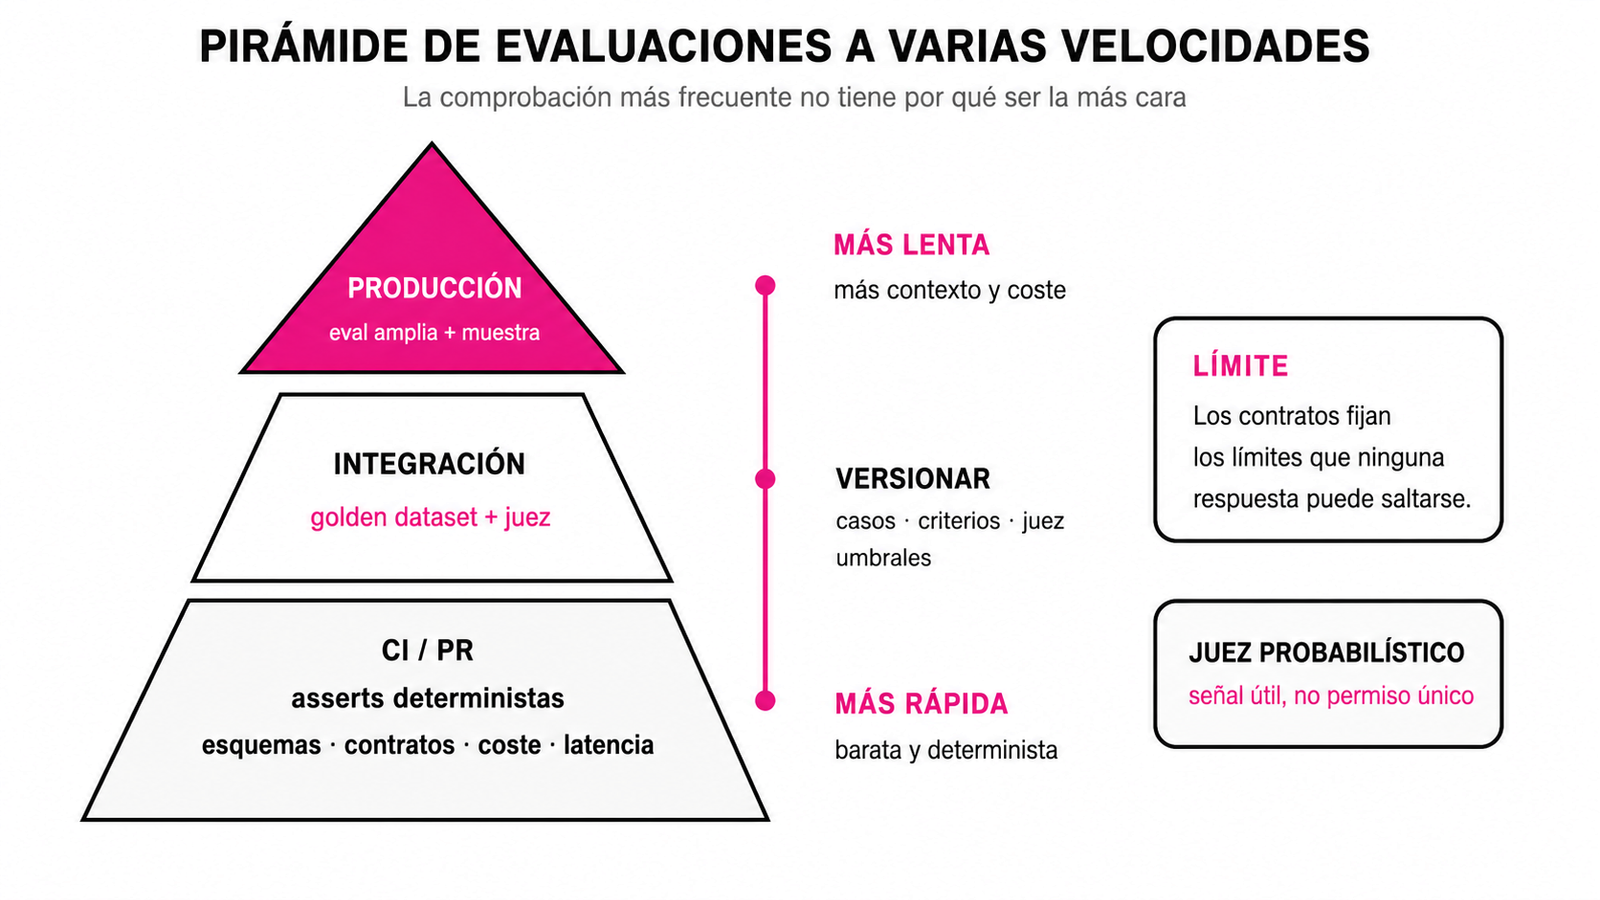
Versionaría casos, criterios, juez, umbrales y desacuerdos humanos. Un juez basado en un modelo es una señal útil pero ruidosa: no debería convertir una puntuación única en permiso para ejecutar una acción de alto impacto. Las evaluaciones detectan deriva y regresiones; los contratos deterministas siguen fijando los límites que una respuesta nunca puede saltarse.
La comparación importante no es con un vibe coding deliberadamente desordenado, sino con un equipo que ya trabaja con pruebas, revisión, ADR y CI bloqueante, pero no trata una especificación como contrato integrado. SDD aporta valor solo si reduce decisiones perdidas, duplicación o trabajo de revisión sin añadir una carga documental mayor que el problema que resuelve.
La comparación queda así:
| Aspecto | Ingeniería disciplinada sin SDD explícito | SDD con IA bien gobernado |
|---|---|---|
| Entrada | Petición o incidencia, ADR, contratos y conocimiento repartido entre repositorio y documentación | Propósito, alcance, tipos, contratos, límites y criterios versionados |
| Arquitectura | La decide el equipo y se aplica mediante revisión, reglas y pruebas | La decide el equipo y la generación debe respetar la spec y esas reglas |
| Reutilización | Puede estar descrita en catálogos, ADR y convenciones | Módulos y dependencias permitidas aparecen en la spec y en reglas ejecutables |
| Verificación | CI y revisión comprueban el resultado, aunque los criterios pueden vivir separados | La spec enlaza criterios y contratos con comprobaciones antes de integrar el cambio |
| Evaluación de comportamiento | Puede existir un conjunto de pruebas, pero no siempre se actualiza junto al cambio | Casos, criterios y juez versionados; una muestra corta detecta regresiones y la amplia orienta la evolución |
| Documentación | ADR, contratos y guías pueden quedar repartidos entre varios artefactos | La spec puede actuar como referencia de decisiones si se comprueba contra el resultado |
| Refactorización | Cambios manuales guiados por pruebas y contratos | Regeneración posible en componentes aislados con contratos estables |
| Coste humano | Menos trabajo específico de spec, pero más búsqueda entre artefactos | Más diseño y mantenimiento de la spec; menos interpretación si está bien conectada |
| Riesgo residual | Divergencia entre ADR, contratos, código y pruebas | Spec incorrecta, incompleta, rígida o desactualizada |
Algunas herramientas materializan este desplazamiento desde el prompt hacia artefactos de especificación, planificación y tareas. Ayudan a sostener el flujo, pero su existencia no demuestra que SDD reduzca defectos en cualquier tipo de proyecto.
La especificación también puede acumular deuda
SDD desplaza parte de la deuda hacia la especificación. Esta puede quedar obsoleta, contradecir otra, fijar una mala decisión o describir con enorme precisión algo que el producto todavía necesita descubrir. Si el código cambia sin actualizarla, aparece una divergencia entre especificación y código, o spec drift. Si se actualiza solo para reflejar lo que ya hizo el código, deja de dirigir y se convierte en documentación tardía.
Para reducir el riesgo de que quede obsoleta, la especificación se incorpora al ciclo de vida:
- cada cambio identifica la decisión o contrato que modifica;
- CI valida esquemas, ejemplos, contratos y criterios ejecutables;
- la solicitud de integración muestra los cambios en la spec junto al código y las pruebas;
- las excepciones tienen propietario, motivo y fecha de revisión;
- producción aporta señales para corregir supuestos y casos ausentes;
- los artefactos obsoletos se retiran en lugar de conservarse como autoridad ambigua.
La sobreespecificación también genera costes recurrentes. Definir pronto detalles reversibles encarece cada cambio y puede encaminar al modelo con mucha precisión hacia la solución equivocada. Especificaría con rigor propósito, invariantes, interfaces, datos, seguridad y criterios de aceptación. Mantendría abiertas las decisiones locales que sean baratas de cambiar y no alteren contratos.
No daría por demostrada una reducción general de defectos. La evidencia observacional disponible usa indicadores indirectos y no permite saber si los repositorios estudiados aplicaban SDD de forma explícita. Tampoco mide el efecto de herramientas concretas. Adoptar un nombre, una plantilla o una carpeta de especificaciones no demuestra el efecto. Si un equipo ya cuenta con ADR, contratos, pruebas, revisión y CI bloqueante, SDD solo añade valor cuando hace visibles decisiones que antes se perdían o reduce el trabajo de coordinación.
Mediría el efecto local. En familias de cambios comparables observaría el tiempo hasta un resultado estable, la carga de revisión, los defectos, el trabajo rehecho, la comprensión y las divergencias entre spec y código. SDD merece continuidad cuando reduce supuestos y fallos sin imponer un coste documental superior al problema que resuelve. La propia spec necesita propietario, fecha de revisión y una prueba de retirada: ¿qué se pierde si se elimina y qué complejidad deja de mantenerse?
Un registro de deuda para IA generativa que obligue a decidir
Mantendría un registro pequeño que vincule cada deuda a un activo, una evidencia, un propietario y una decisión observable. El objetivo es retirar o controlar la dependencia que genera costes recurrentes, no acumular una lista pendiente de «mejoras».
| Campo | Pregunta que debe responder |
|---|---|
| Activo y dependencia | ¿Qué fuente, índice, modelo, prompt, agente, spec o módulo está afectado? |
| Síntoma y coste recurrente | ¿Qué coste, latencia, fallo, trabajo rehecho o riesgo se repite? |
| Evidencia | ¿Qué medida o incidente demuestra que no es una preferencia estética? |
| Alcance y consumidores | ¿Qué respuestas, equipos, usuarios o contratos dependen de ello? |
| Propietario | ¿Quién puede aceptar, mitigar o retirar la deuda? |
| Control ausente | ¿Qué prueba, contrato, traza o mecanismo de reversión falta? |
| Condición de retirada | ¿Qué componente, ruta, excepción o dato debe desaparecer? |
| Coste del control | ¿Qué latencia, almacenamiento, revisión o mantenimiento añade el control? |
| Prueba de retirada | ¿Qué evidencia permite eliminarlo sin perder el objetivo que protege? |
| Decisión y fecha | ¿Cuándo se revisa y qué umbral cambia la prioridad? |
Para llevar un piloto de RAG o de agentes a producción no intentaría implantar todo el marco a la vez. Empezaría por un límite acotado del piloto y por cinco controles; el orden exacto debe cambiar según la irreversibilidad, la falta de observabilidad y el impacto del fallo:
- inventario y propietario de las fuentes, índices, modelos, prompts, herramientas y especificaciones que entren en ese límite;
- autorización por defecto denegada y permisos mínimos para cada consulta o acción;
- manifiesto y traza que permitan rastrear una ejecución sin guardar secretos;
- prueba bloqueante para el fallo de mayor impacto identificado, junto con una evaluación de calidad versionada. Por ejemplo: un recurso revocado sigue apareciendo en RAG, un reintento duplica una acción o esta se da por completada sin confirmación;
- despliegue gradual, criterio de promoción y procedimiento de parada, reversión o compensación ensayado.
Este mínimo crea las condiciones para detectar y localizar un deterioro, sin certificar que el sistema sea seguro ni correcto. Cada control debe registrar además quién lo mantiene, qué latencia, almacenamiento o revisión añade, qué fallo pretende contener y con qué umbral se retiraría. También reduce el riesgo de que un piloto provoque una operación irreversible sin los controles previstos.
No exigiría los cinco controles con la misma profundidad en todos los pilotos. En exploración bastan una versión del modelo y del prompt, un conjunto pequeño de casos, una ruta sin escritura y una forma de apagarla. En asesoramiento añadiría recuperación autorizada, abstención, evaluación versionada y muestreo de producción. En acción o alto impacto aplicaría los cinco, además de idempotencia, confirmación y compensación cuando correspondan. El criterio es qué evidencia y qué límite aportan una reducción del riesgo proporcional al valor del recorrido.
No usaría como medida principal el coste por token, la unidad de consumo con la que se factura el uso de muchos modelos. Puede bajar mientras suben las respuestas inválidas, los reintentos y la revisión humana. Mediría el coste por respuesta válida —una respuesta que cumple los criterios fijados— o por cambio estable —uno que supera las pruebas y no exige una corrección inmediata—. Del mismo modo, calcularía la latencia p95: el valor que el 95 % de las peticiones de una ventana no supera; el 5 % restante tarda más. Separaría esa medida por etapa para localizar si el coste está en la fuente, la recuperación, el reranker, el modelo o una herramienta.
Para RAG observaría la precisión y la cobertura de la recuperación, la fidelidad, la relevancia, la abstención, la vigencia, los conflictos y la autorización por segmento. Para el código generado observaría el tiempo de revisión, las rondas de cambios, las pruebas añadidas, el trabajo rehecho, los defectos, las reversiones, el tiempo de recuperación y la comprensión necesaria para mantenerlo.
Antes de probar un cambio fijaría la intervención, la unidad de análisis, la población, la ventana y el denominador. También dejaría establecidos la línea base o el grupo de comparación, el efecto mínimo relevante y las métricas de control de seguridad, coste y latencia. Cuando sea posible usaría exposición aleatoria o gradual; en los demás casos registraría los factores que pueden confundir la lectura. Los resultados se revisan por segmento y con su incertidumbre, no como una única puntuación.
La prioridad más alta no siempre corresponde al fallo más visible. Atacaría primero la deuda que impide medir, reconstruir o revertir, porque encarece cualquier mejora posterior. Después priorizaría por frecuencia, exposición, impacto y velocidad de crecimiento. Suele convenir retirar una dependencia marginal que falla cada semana antes que acometer una refactorización elegante sin efecto operativo.
El artículo de 2015 sigue siendo útil porque obliga a mirar más allá del modelo. El código específico del algoritmo ocupa una parte pequeña; fuentes, índices, permisos, cachés, evaluadores, proveedores y decisiones de operación forman el sistema que realmente hay que mantener. En la IA generativa hay más piezas, más artefactos y más velocidad, pero también mejores contratos, evaluaciones y automatización para gobernarlos.
El nivel de control debe corresponder al daño posible: evaluaciones y reversión ligera cuando todavía se está descubriendo el producto; autorización, idempotencia y trazabilidad cuando el sistema actúa sobre personas, dinero, datos sensibles o varios inquilinos. La velocidad de iteración también es una métrica de supervivencia, pero deja de ser una ventaja cuando un fallo es irreversible, invisible o demasiado caro de reparar.
Más de 22 años construyendo y evolucionando plataformas de aprendizaje en producción.
Sobre Alberto Lara y su trayectoria profesional →Seguir leyendo
- Lo que he aprendido trabajando con agentes en desarrollo de software
Dieciséis meses con agentes aplicados al desarrollo de software en repositorios reales. Los errores que he cometido, lo que me ha funcionado y cómo trabajo ahora.
- Qué decisiones de arquitectura deja abiertas una spec
Una especificación reduce ambigüedad, pero no elige por sí sola la arquitectura. Un caso de concurrencia muestra qué debe decidir todavía el equipo.
- Spec-Driven Development con IA: qué debe contener una spec
Una spec útil conserva las decisiones que deben llegar al diseño, el código y las pruebas. Esta guía explica qué incluye, cuánta autoridad recibe y dónde deja de bastar.